
Pythonで日付データを扱う方法【pandasのto_datetime・曜日・月初・週単位の集計】
 酒井 裕麻株式会社Bistro 代表取締役社長
売上データの分析では、「曜日ごとの傾向は?」「週ごとの推移は?」のように、日付を使った集計が欠かせません。ところが、CSVから読み込んだ日付は、そのままでは「ただの文字」として扱われていることが多く、思ったように集計できません。
この記事では、Google ColabのPython(pandas)で、日付を変換する・取り出す・計算する方法と、曜日別・週別の集計を解説します。
同じことをRのlubridateで行う方法は、Rで日付データを扱う方法で紹介しています。
文字の日付を日付型に変換する
pd.to_datetime() で、文字の日付を日付型(datetime)に変換します。書き方がばらばらな日付も、format="mixed" を指定すると、まとめて変換できます。
import pandas as pd

x = pd.Series(["2026-01-05", "2026/02/14", "20260331"])
pd.to_datetime(x, format="mixed")
実行結果
0   2026-01-05
1   2026-02-14
2   2026-03-31
dtype: datetime64[ns]日本語の日付は、format で書き方を指定します。%Y は4けたの年、%m は月、%d は日を表します。
pd.to_datetime("2026年3月1日", format="%Y年%m月%d日")実行結果
Timestamp('2026-03-01 00:00:00')CSVを読み込むときに、parse_dates で日付の列を指定しておくと、最初から日付型として読み込めます。
sales = pd.read_csv("sales.csv", parse_dates=["date"])よく使う日付の書き方の記号
| 記号 | 意味 | 例 |
|---|---|---|
%Y |
年(4けた) | 2026 |
%m |
月(2けた) | 03 |
%d |
日(2けた) | 15 |
%H / %M / %S |
時 / 分 / 秒 | 21 / 30 / 00 |
%a |
曜日(英語の略) | Sun |
年・月・日・曜日を取り出す
日付型にすると、年・月・日などを取り出せます。1つの日付(Timestamp)なら .year のように、表の列(Series)なら .dt.year のように書きます。
d = pd.Timestamp("2026-03-15")
print(d.year, d.month, d.day)
print("曜日の番号:", d.dayofweek)
print("曜日の名前:", d.day_name())
実行結果
2026 3 15
曜日の番号: 6
曜日の名前: Sunday
dayofweek は、月曜日が0、日曜日が6の番号です。曜日の名前は英語で返るので、日本語にしたいときは、番号を使って変換します。
WEEKDAYS = ["月", "火", "水", "木", "金", "土", "日"]
WEEKDAYS[d.dayofweek]
実行結果
'日'日付の計算
○日後・○か月後
日数の足し算は pd.Timedelta、月の足し算は pd.DateOffset を使います。
print(d + pd.Timedelta(days=10))
print(d + pd.DateOffset(months=1))
実行結果
2026-03-25 00:00:00
2026-04-15 00:00:00
DateOffset(months=1) は、月末の日付もうまく扱ってくれます。たとえば1月31日の1か月後は、存在しない2月31日ではなく、2月28日になります。
pd.Timestamp("2026-01-31") + pd.DateOffset(months=1)実行結果
Timestamp('2026-02-28 00:00:00')月初・月末
月初は .to_period("M").start_time、月末は pd.offsets.MonthEnd で求められます。
print("月初:", d.to_period("M").start_time.date())
print("月末:", (d + pd.offsets.MonthEnd(0)).date())
実行結果
月初: 2026-03-01
月末: 2026-03-31
to_period("M") は「2026年3月」という月の単位に変換する操作で、月ごとの集計でもよく使います。
2つの日付の差(日数)
日付どうしを引き算すると、差が求められます。.days で日数を取り出せます。
(pd.Timestamp("2026-03-31") - pd.Timestamp("2026-01-01")).days実行結果
89時刻を含むデータ
時刻を含むデータも、同じように変換できます。tz で、タイムゾーン(日本時間なら "Asia/Tokyo")を指定できます。
dt = pd.Timestamp("2026-03-15 21:30:00", tz="Asia/Tokyo")
print(dt)
print("時:", dt.hour)
実行結果
2026-03-15 21:30:00+09:00
時: 21GA4やBigQueryのデータは、時刻がUTC(世界標準時)で記録されていることがよくあります。日本時間に直すには、tz_convert("Asia/Tokyo") を使います。日付をまたぐ集計では、9時間のずれに注意しましょう。
utc = pd.Timestamp("2026-03-15 18:00:00", tz="UTC")
utc.tz_convert("Asia/Tokyo")
実行結果
Timestamp('2026-03-16 03:00:00+0900', tz='Asia/Tokyo')実践:曜日別・週別に集計する
売上データ sales.csv(2026年1〜3月の日別データ)を使って、曜日別と週別に集計してみましょう。
sales = pd.read_csv("https://www.bistro.business/files/r/sales.csv", parse_dates=["date"])

sales["wd"] = sales["date"].dt.dayofweek                          # 月曜=0 … 日曜=6
sales["wday"] = sales["wd"].map(lambda i: WEEKDAYS[i])            # 日本語の曜日
sales["week"] = sales["date"].dt.to_period("W-SUN").dt.start_time  # その週の月曜日
sales["month"] = sales["date"].dt.to_period("M")                  # 月

sales[["date", "wd", "wday", "week", "month"]].head(3)
実行結果
        date  wd wday       week    month
0 2026-01-01   3    木 2025-12-29  2026-01
1 2026-01-01   3    木 2025-12-29  2026-01
2 2026-01-01   3    木 2025-12-29  2026-01
to_period("W-SUN") は「日曜日で終わる週」という意味で、start_time でその週の月曜日の日付が取れます。2026年1月1日は木曜日なので、週の始まりは前の年の12月29日(月曜日)になっています。
曜日別の平均客数
by_wday = sales.groupby(["wd", "wday"], as_index=False)["customers"].mean().round(1)
by_wday
実行結果
   wd wday  customers
0   0    月       94.2
1   1    火       95.6
2   2    水       94.0
3   3    木       93.3
4   4    金       93.6
5   5    土      124.0
6 6 日 121.0wd(番号)でもグループ化しておくと、月曜日から順に並びます。曜日の名前だけでグループ化すると、文字の順(土・日・月…)に並んでしまうので注意しましょう。
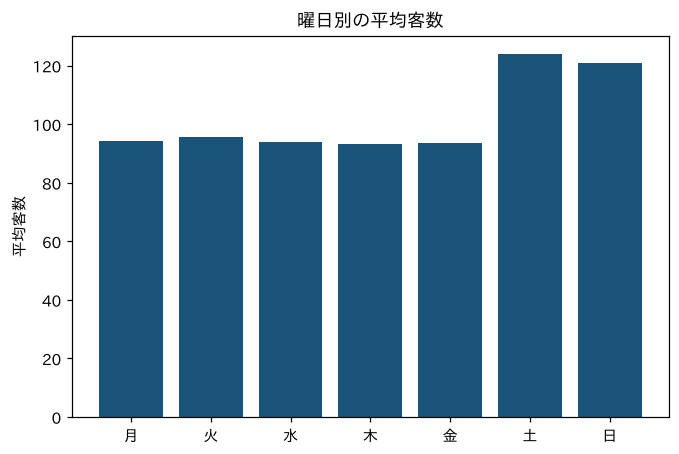
曜日別のグラフ
!pip install -q matplotlib-fontjaimport matplotlib.pyplot as plt
import matplotlib_fontja
fig, ax = plt.subplots(figsize=(7, 4.5))
ax.bar(by_wday["wday"], by_wday["customers"], color="#195379")
ax.set_title("曜日別の平均客数")
ax.set_ylabel("平均客数")
plt.show()
土日に客数が多いことがわかります。
週単位・月単位の集計
週の列でグループ化すると、週ごとの売上がわかります。
weekly = sales.groupby("week").agg(sales=("sales", "sum"), days=("date", "nunique"))
weekly.head()
実行結果
              sales  days
week
2025-12-29  4021290     4
2026-01-05  6718490     7
2026-01-12  6488660     7
2026-01-19  6447720     7
2026-01-26 6773590 7最初の週は、1月1日〜4日の4日分しかないので、売上が小さくなっています。週ごとの推移をグラフにするときは、7日分そろった週だけを使いましょう(weekly.query("days == 7"))。
月ごとの集計も同じです。
(sales.groupby("month")["sales"].sum() / 10000).round(1)実行結果
month
2026-01    2931.6
2026-02    2606.6
2026-03    2918.7
Freq: M, Name: sales, dtype: float64日付を行の名前(インデックス)にして、resample() を使う方法もあります。"W-MON" のような指定で、週の区切りも変えられます。
daily = sales.groupby("date")["sales"].sum()
daily.resample("MS").sum().head()  # MS = 月初めごと
実行結果
date
2026-01-01    29316150
2026-02-01    26065990
2026-03-01    29187220
Freq: MS, Name: sales, dtype: int64
まとめ
- 文字の日付は
pd.to_datetime()で日付型に変換する。CSVならparse_dates - 年・月・曜日は、列なら
.dt.year・.dt.month・.dt.dayofweekで取り出す - 曜日の番号は月曜が0。日本語の曜日は、番号からリストで変換する
- ○日後は
Timedelta、○か月後はDateOffset、月の単位はto_period("M") - 週の始まりの日付は
to_period("W-SUN").dt.start_time - UTCのデータは、日本時間に直してから集計する
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。