
Pythonでコレスポンデンス分析をする方法【ブランドイメージのポジショニングマップ】
 酒井 裕麻株式会社Bistro 代表取締役社長
「自社ブランドは、競合と比べてどんなイメージを持たれているのか」——ブランドイメージのアンケート結果を、1枚の地図(ポジショニングマップ)にまとめられるのが、コレスポンデンス分析です。
この記事では、Google ColabのPythonでコレスポンデンス分析を行い、ブランドとイメージの関係を地図にする方法を解説します。
同じ分析をRで行う方法は、Rでコレスポンデンス分析をする方法で紹介しています。
コレスポンデンス分析とは
コレスポンデンス分析は、クロス集計表の行と列の関係を、2次元の地図に表す分析です。
- よく一緒に選ばれる「ブランド」と「イメージ」が、地図の上で同じ方向に配置される
- 似たイメージを持たれているブランドどうしが、近くに配置される
マーケティングリサーチでは、ブランドイメージの比較や、商品と利用シーンの関係の整理などによく使われます。
この記事で使うデータ
架空のブランドイメージ調査 brand_image.csv を使います。5つのブランドについて、それぞれのイメージに当てはまると答えた人数をまとめたクロス集計表です。
import pandas as pd
import numpy as np

tab = pd.read_csv("https://www.bistro.business/files/r/brand_image.csv", index_col="brand")
tab
実行結果
       高級感  親しみやすい  おしゃれ  安い  信頼できる  革新的
brand
ブランドA   62      15    40   5     48   22
ブランドB   12      58    20  45     25    8
ブランドC   30      22    55  10     18   50
ブランドD    8      40    12  60     30    6
ブランドE   45      18    25   8     60   35
index_col="brand" で、ブランドの列を行の名前にしています。コレスポンデンス分析では、このように行の名前と列の名前があり、中身が数字だけの表を使います。
コレスポンデンス分析を計算する
Pythonには、Rの ca パッケージのような定番のライブラリがないため、ここではnumpyで計算する関数を作ります。数行で書けるので、仕組みの理解にも役立ちます。
def correspondence_analysis(table):
    """コレスポンデンス分析(行と列の座標、寄与率)を計算する"""
    N = table.to_numpy(dtype=float)
    P = N / N.sum()                 # 全体を1とした割合
    r = P.sum(axis=1)               # 行(ブランド)の割合
    c = P.sum(axis=0)               # 列(イメージ)の割合
    # 「独立だった場合」からのずれを標準化した行列
    S = (P - np.outer(r, c)) / np.sqrt(np.outer(r, c))
    U, s, Vt = np.linalg.svd(S, full_matrices=False)   # 特異値分解
    row = U * s / np.sqrt(r[:, None])                   # 行の座標
    col = Vt.T * s / np.sqrt(c[:, None])                # 列の座標
    k = min(N.shape) - 1                                # 意味のある軸の数
    names = [f"第{i + 1}軸" for i in range(k)]
    return (
        pd.DataFrame(row[:, :k], index=table.index, columns=names),
        pd.DataFrame(col[:, :k], index=table.columns, columns=names),
        pd.Series(s[:k] ** 2 / (s[:k] ** 2).sum(), index=names),
    )

rows, cols, inertia = correspondence_analysis(tab)
計算の流れは、次のとおりです。
- 表の数字を、全体を1とした割合にする
- 「ブランドとイメージに関係がない(独立)」としたときの割合と、実際の割合のずれを計算する
- そのずれを、特異値分解という計算で、重要な方向(軸)から順に取り出す
ずれが大きい組み合わせ(よく一緒に選ばれるブランドとイメージ)ほど、地図の上で同じ方向に配置されます。
※ライブラリを使いたい場合は、!pip install prince で、コレスポンデンス分析ができる prince というライブラリをインストールして使う方法もあります。
寄与率:地図がどれくらい情報を表しているか
(inertia * 100).round(1)実行結果
第1軸    76.1
第2軸    17.2
第3軸     4.1
第4軸     2.5
dtype: float64第1軸が76.1%、第2軸が17.2%で、2つの軸を合わせて93.3%の情報を表せています。2次元の地図で、元のクロス集計表の関係をほぼ再現できているといえます。
※累積の寄与率が低い(たとえば60%以下)場合は、2次元の地図だけでは表しきれない関係がある、ということに注意して読み取りましょう。
座標を確認する
ブランドとイメージの、地図の上での座標(第1軸・第2軸)を確認します。
rows.iloc[:, :2].round(3)実行結果
         第1軸    第2軸
brand
ブランドA  0.462 -0.220
ブランドB -0.629  0.058
ブランドC  0.381  0.457
ブランドD -0.790 -0.069
ブランドE  0.365 -0.216
cols.iloc[:, :2].round(3)実行結果
          第1軸    第2軸
高級感     0.506 -0.237
親しみやすい -0.562  0.089
おしゃれ    0.325  0.290
安い     -0.970  0.007
信頼できる   0.118 -0.345
革新的     0.496  0.340
第1軸のプラス側には「高級感」「革新的」「おしゃれ」、マイナス側には「安い」「親しみやすい」が来ています。
なお、軸の向き(プラス・マイナス)は、計算の都合で反転することがあります。反転しても、地図の読み方は変わりません。
ポジショニングマップを作る
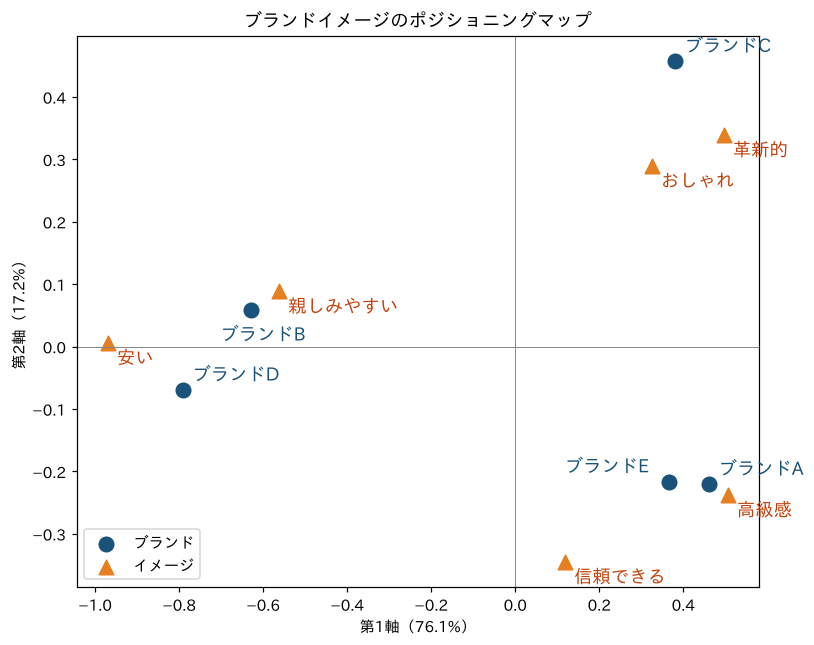
ブランドとイメージを、1つの散布図に重ねて描きます。
!pip install -q matplotlib-fontjaimport matplotlib.pyplot as plt
import matplotlib_fontja
fig, ax = plt.subplots(figsize=(8, 6.5))
ax.axhline(0, color="grey", linewidth=0.6)
ax.axvline(0, color="grey", linewidth=0.6)
ax.scatter(rows["第1軸"], rows["第2軸"], s=90, color="#195379", label="ブランド")
ax.scatter(cols["第1軸"], cols["第2軸"], s=90, marker="^", color="#E67E22", label="イメージ")
shift = {"ブランドE": (-68, 6), "ブランドB": (-20, -20)} # 重なるラベルだけずらす
for name, (x, y) in rows.iloc[:, :2].iterrows():
ax.annotate(name, (x, y), xytext=shift.get(name, (6, 6)), textcoords="offset points",
color="#195379", fontsize=12)
for name, (x, y) in cols.iloc[:, :2].iterrows():
ax.annotate(name, (x, y), xytext=(6, -14), textcoords="offset points", color="#C2410C", fontsize=12)
ax.set_title("ブランドイメージのポジショニングマップ")
ax.set_xlabel(f"第1軸({inertia.iloc[0] * 100:.1f}%)")
ax.set_ylabel(f"第2軸({inertia.iloc[1] * 100:.1f}%)")
ax.legend(loc="lower left")
plt.show()
ブランドを青い丸、イメージをオレンジの三角で表しています。xytext で、ラベルを点から少しずらして表示しています。重なってしまうラベルは、shift で個別に位置を調整しています。
マップの読み方
軸の意味を考える
まず、それぞれの軸の両端にどんなイメージがあるかを見ます。
| 軸 | マイナス側 | プラス側 | 解釈 |
|---|---|---|---|
| 第1軸(横) | 安い・親しみやすい | 高級感・革新的・おしゃれ | 「手頃さ ⇔ プレミアム感」 |
| 第2軸(縦) | 信頼できる・高級感 | おしゃれ・革新的 | 「伝統・信頼 ⇔ 新しさ・トレンド」 |
ブランドの位置を読む
| ブランド | 位置 | 近いイメージ | ポジション |
|---|---|---|---|
| ブランドA・E | 右下 | 高級感・信頼できる | 信頼感のあるプレミアムブランド |
| ブランドC | 右上 | おしゃれ・革新的 | トレンド感のある新しいブランド |
| ブランドB・D | 左 | 安い・親しみやすい | 手頃で身近なブランド |
ブランドAとEは近い位置にあり、イメージが似ている=競合関係にあることがわかります。差別化を図るなら、どのイメージを強めるべきか、といった議論の材料になります。
読み取るときの注意点
- ブランドとイメージの距離は、厳密な比較ではない:このような地図(対称マップ)では、同じ種類どうし(ブランドとブランド、イメージとイメージ)の距離は解釈できますが、ブランドとイメージの距離はあくまで「方向が近いか」の目安です。
- 原点に近いものは特徴が弱い:原点付近にあるブランドは、どのイメージにも偏っていない「平均的な」ブランドです。
- 元の数字も必ず確認する:地図だけで判断せず、クロス集計表の数字と見比べて、解釈がずれていないかを確かめましょう。行ごとの割合(
tab.div(tab.sum(axis=1), axis=0))を見ると、比べやすくなります。
まとめ
- コレスポンデンス分析は、クロス集計表の行と列の関係を、2次元の地図に表す方法
- Pythonでは、numpyの特異値分解(
np.linalg.svd)を使って数行で計算できる - 寄与率で、地図がどれくらい元の表を表せているかを確認する
- 軸の両端のイメージから軸の意味を考え、ブランドの位置を読み取る
- 地図の読み取りは、元のクロス集計表の数字とあわせて確認する
アンケートの評価項目(1〜5点など)を要約して地図にしたいときは、主成分分析が向いています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。