
Pythonで広告の残存効果(アドストック)を計算する方法【MMMの基礎】
 酒井 裕麻株式会社Bistro 代表取締役社長
テレビCMを流した週だけでなく、その翌週や翌々週にも売上が伸びている——そんな経験はないでしょうか。広告の効果は、出稿したその週だけで消えるわけではなく、しばらく残りながら少しずつ弱まっていきます。この残存効果をアドストックと呼びます。
この記事では、Google ColabのPythonでアドストックを計算する方法と、売上データから「効果がどれくらい残るか(残存率)」を推定する方法を解説します。マーケティング・ミックス・モデリング(MMM)の基礎となる考え方です。
同じ分析をRで行う方法は、Rで広告の残存効果(アドストック)を計算する方法で紹介しています。MMMそのものについては、マーケティングミックスモデリング(MMM)とは?をご覧ください。
アドストックの考え方
アドストックは、次の式で計算します。
今週のアドストック = 今週の出稿量 + 残存率 × 先週のアドストック
残存率は0〜1の値で、「先週までの広告効果のうち、今週にどれだけ残るか」を表します。
- 残存率0.5:効果が毎週半分ずつ残る(半減期は1週)
- 残存率0.7:効果が毎週7割ずつ残る(長く効く)
- 残存率0:効果は出稿した週だけ(残存効果なし)
Pythonでアドストックを計算する
関数を作る
式のとおりに、1週目から順番に計算する関数を作ります。
import numpy as np

def adstock(x, rate):
    """出稿量 x に、残存率 rate のアドストックを適用する"""
    out = np.zeros(len(x))
    for i in range(len(x)):
        out[i] = x[i] + (rate * out[i - 1] if i > 0 else 0)
    return out
1週目から順番に、「今週の出稿量 + 残存率 × 先週のアドストック」を計算しています。
計算してみる
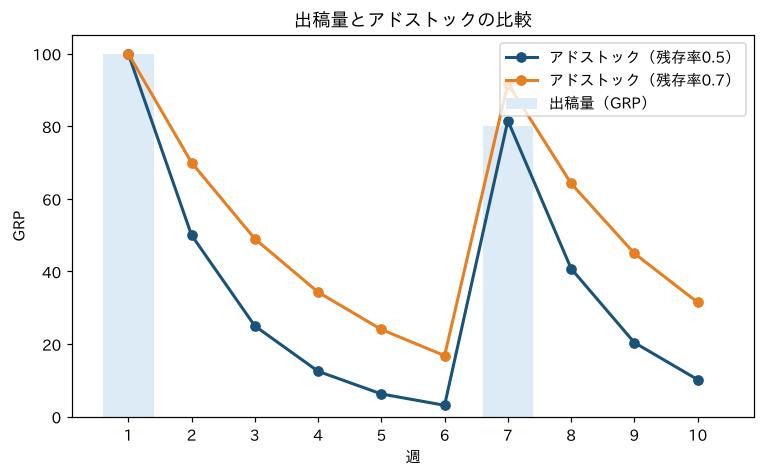
1週目に100、7週目に80のGRP(テレビCMの出稿量の単位)を出稿した場合を考えます。
grp = np.array([100, 0, 0, 0, 0, 0, 80, 0, 0, 0])
print(adstock(grp, 0.5).round(1))
print(adstock(grp, 0.7).round(1))
実行結果
[100.   50.   25.   12.5   6.2   3.1  81.6  40.8  20.4  10.2]
[100.   70.   49.   34.3  24.   16.8  91.8  64.2  45.   31.5]
残存率0.5では、100 → 50 → 25 … と毎週半分になっていきます。7週目は、新しい出稿80に前週から残った1.6が足されて81.6になっています。残存率0.7では、効果がより長く残ることがわかります。
グラフにして、元の出稿量と比べてみましょう。
!pip install -q matplotlib-fontjaimport matplotlib.pyplot as plt
import matplotlib_fontja
weeks = np.arange(1, 11)
fig, ax = plt.subplots(figsize=(8, 4.5))
ax.bar(weeks, grp, color="#DCEBF5", label="出稿量(GRP)")
ax.plot(weeks, adstock(grp, 0.5), marker="o", color="#195379", linewidth=2, label="アドストック(残存率0.5)")
ax.plot(weeks, adstock(grp, 0.7), marker="o", color="#E67E22", linewidth=2, label="アドストック(残存率0.7)")
ax.set_xticks(weeks)
ax.set_title("出稿量とアドストックの比較")
ax.set_xlabel("週")
ax.set_ylabel("GRP")
ax.legend()
plt.show()
scipyを使うともっと簡単
この計算は、信号処理の分野で使われる「再帰フィルター」と同じものです。scipyの lfilter() を使うと、1行で計算できます。データが多いときは、こちらのほうが速く計算できます。
from scipy.signal import lfilter

def adstock_fast(x, rate):
    return lfilter([1], [1, -rate], x)

adstock_fast(grp, 0.5).round(1)
実行結果
array([100. ,  50. ,  25. ,  12.5,   6.2,   3.1,  81.6,  40.8,  20.4,
        10.2])
自作の関数と同じ結果になりました。Rの stats::filter(x, rate, method = "recursive") と同じ計算です。
売上データから残存率を推定する
実際の分析では、残存率はわかっていません。そこで、いろいろな残存率でアドストックを計算し、売上を最もよく説明できる残存率を探します。
ここでは、52週分のテレビCMの出稿量と売上のシミュレーションデータを作って試してみます(このデータは、本当の残存率を0.6にして作っています)。
import pandas as pd

rng = np.random.default_rng(3)
n_weeks = 52
tv = np.where(rng.uniform(size=n_weeks) < 0.35, rng.integers(50, 151, n_weeks), 0)  # 約35%の週にCMを出稿
true_ad = adstock(tv, 0.6)
sales = np.round(1000 + 2.5 * true_ad + rng.normal(0, 60, n_weeks))

df = pd.DataFrame({"week": range(1, n_weeks + 1), "tv": tv, "sales": sales})
df.head()
実行結果
   week   tv   sales
0     1   71  1115.0
1     2  120  1491.0
2     3    0  1243.0
3     4    0  1124.0
4 5 113 1267.0残存率を0から0.9まで0.1刻みで変えて、それぞれ回帰分析の決定係数(R²)を比べます。回帰分析の方法は、Pythonで回帰分析をする方法で解説しています。
import statsmodels.api as sm

def r2_for(rate):
    X = sm.add_constant(adstock(df["tv"].to_numpy(), rate))
    return sm.OLS(df["sales"], X).fit().rsquared

result = pd.DataFrame({"rate": np.round(np.arange(0, 1.0, 0.1), 1)})
result["r2"] = result["rate"].map(r2_for).round(3)
result
実行結果
   rate     r2
0   0.0  0.554
1   0.1  0.617
2   0.2  0.679
3   0.3  0.737
4   0.4  0.788
5   0.5  0.823
6   0.6  0.833
7   0.7  0.793
8   0.8  0.657
9   0.9  0.252
sm.add_constant() は、回帰分析の式に切片を加えるための関数です。
決定係数が最も高くなる残存率を確認します。
best = result.loc[result["r2"].idxmax(), "rate"]
best
実行結果
np.float64(0.6)本当の残存率(0.6)に近い値が見つかりました。
もっと細かく推定する
0.1刻みではなく、もっと細かく推定したいときは、scipyの minimize_scalar() で、決定係数が最も高くなる残存率を探せます。
from scipy.optimize import minimize_scalar

opt = minimize_scalar(lambda r: -r2_for(r), bounds=(0, 0.95), method="bounded")
print(f"推定した残存率: {opt.x:.3f}")
実行結果
推定した残存率: 0.577推定した残存率でアドストックを計算し、回帰分析の係数を確認します。
model = sm.OLS(df["sales"], sm.add_constant(adstock(df["tv"].to_numpy(), opt.x))).fit()
model.params.round(2)
実行結果
const    1000.36
x1          2.69
dtype: float64
const は広告がなかったときの売上(ベース)、x1 はアドストック1単位あたりの売上の増加です。データを作ったときの値(ベース1000、効果2.5)に近い値が推定できました。
実務のMMMでは
実際のMMMでは、ここで紹介した方法に加えて、次のような点も考えます。
- 複数の媒体:テレビ・Web広告・チラシなど、媒体ごとに残存率が違う
- 飽和効果:広告を増やしすぎると、効果が頭打ちになる(収穫逓減)
- 季節性・ほかの要因:季節、価格、キャンペーンなど、広告以外の要因も売上に影響する
- ツール:GoogleのMeridianや、MetaのRobynなど、MMMのためのオープンソースのツールもPythonやRで使えます
アドストックは、こうしたMMMの土台になる考え方です。まずは自社のデータで、残存率を推定するところから試してみてください。
まとめ
- アドストックは「今週の出稿量 + 残存率 × 先週のアドストック」で計算する
- Pythonでは、forループの関数や、scipyの
lfilter()で計算できる - 残存率は、いろいろな値で回帰分析をして、売上を最もよく説明する値を探す
minimize_scalar()を使えば、細かい値まで推定できる- 実務のMMMでは、複数の媒体・飽和効果・季節性もあわせて考える
株式会社Bistroでは、MMMによる広告効果の可視化と、広告運用への活用をご支援しています。お気軽にご相談ください。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。