
Pythonで回帰分析をする方法【statsmodelsのols・単回帰と重回帰・結果の読み方】
 酒井 裕麻株式会社Bistro 代表取締役社長
「広告費を増やすと、客数はどれくらい増えるのか」——このような、ある数値が、ほかの数値によってどれくらい変わるかを調べるのが回帰分析です。
この記事では、Google ColabのPythonで、statsmodelsを使った回帰分析のやり方と、結果の読み方を解説します。単回帰では見えなかった広告費の効果が、重回帰で見えてくる様子も紹介します。
同じ分析をRで行う方法は、Rで回帰分析をする方法で紹介しています。
回帰分析とは
回帰分析は、説明したい数値(目的変数)を、それに影響する数値(説明変数)の式で表す分析です。
客数 = 切片 + 係数 × 広告費
このように説明変数が1つのものを単回帰分析、複数のものを重回帰分析と呼びます。係数を見ると、「広告費を1単位増やすと、客数がどれくらい増えるか」がわかります。
データの準備
売上データ(sales.csv)を、日付×店舗ごとの「客数」と「広告費(千円)」に集計し、土日かどうかを表す weekend 列(土日:1、平日:0)を作ります。
import pandas as pd

sales = pd.read_csv("https://www.bistro.business/files/r/sales.csv", parse_dates=["date"])

daily = sales.groupby(["date", "store"], as_index=False).agg(
    customers=("customers", "sum"), ad_spend=("ad_spend", "sum")
)
daily["ad_spend"] = daily["ad_spend"] / 1000
daily["weekend"] = (daily["date"].dt.dayofweek >= 5).astype(int)  # 土日=1
daily.head(3)
実行結果
        date store  customers  ad_spend  weekend
0 2026-01-01   新宿店        365      50.0        0
1 2026-01-01   横浜店        235      37.0        0
2 2026-01-01   渋谷店        253      55.0        0
dayofweek は月曜日が0、土曜日が5、日曜日が6なので、5以上を土日としています。
単回帰分析:広告費だけで客数を説明する
Pythonで回帰分析をするときは、statsmodelsというライブラリを使うのがおすすめです。Rの lm() と同じように、目的変数 ~ 説明変数 という式の形で書けて、結果の表も詳しく出せます。statsmodelsはColabに最初から入っています。
import statsmodels.formula.api as smf

model1 = smf.ols("customers ~ ad_spend", data=daily).fit()
print(model1.summary().tables[1])
print(f"決定係数 R-squared: {model1.rsquared:.4f}")
実行結果
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept    288.5742     18.648     15.475      0.000     251.860     325.289
ad_spend       0.3556      0.349      1.020      0.309      -0.331       1.042
==============================================================================
決定係数 R-squared: 0.0039
summary() で、結果の表をすべて表示できます。ここでは、係数の表(tables[1])と決定係数だけを表示しています。
広告費の係数(coef)は0.36ですが、p値(P>|t|)は0.309で有意ではありません。決定係数(R-squared)も0.004と、客数の変動をほとんど説明できていません。
「広告費は客数に関係ない」と結論づけたくなりますが、本当にそうでしょうか。
重回帰分析:曜日と店舗も考慮する
客数は、店舗の規模や、平日か土日かによっても大きく変わります。それらも説明変数に入れて、重回帰分析をしてみましょう。説明変数は + でつなぎます。
model2 = smf.ols("customers ~ ad_spend + weekend + C(store)", data=daily).fit()
print(model2.summary().tables[1])
print(f"決定係数 R-squared: {model2.rsquared:.3f}")
print(f"自由度調整済み決定係数 Adj. R-squared: {model2.rsquared_adj:.3f}")
実行結果
===================================================================================
                      coef    std err          t      P>|t|      [0.025      0.975]
-----------------------------------------------------------------------------------
Intercept         305.9930      5.970     51.251      0.000     294.237     317.749
C(store)[T.横浜店]  -136.2690      3.129    -43.547      0.000    -142.430    -130.108
C(store)[T.渋谷店]   -67.2405      3.130    -21.480      0.000     -73.404     -61.077
ad_spend            0.8373      0.103      8.107      0.000       0.634       1.041
weekend            87.8095      2.840     30.922      0.000      82.218      93.401
===================================================================================
決定係数 R-squared: 0.915
自由度調整済み決定係数 Adj. R-squared: 0.914
C(store) は、店舗を「カテゴリ(グループ)」として扱う、という意味です。print(model2.summary()) とすると、決定係数やデータの件数なども含めた、すべての結果が表示されます。
結果の読み方
係数(coef)
| 説明変数 | 係数 | 読み方 |
|---|---|---|
| Intercept | 305.99 | 切片(基準となる店舗・平日・広告費0のときの客数) |
| C(store)[T.横浜店] | -136.27 | 横浜店は新宿店より約136人少ない |
| C(store)[T.渋谷店] | -67.24 | 渋谷店は新宿店より約67人少ない |
| ad_spend | 0.84 | 広告費を1,000円増やすと、客数が約0.84人増える |
| weekend | 87.81 | 土日は平日より約88人多い |
店舗のような文字の列を入れると、statsmodelsは自動的に1つの店舗を基準(ここでは文字の順で最初の「新宿店」)にして、ほかの店舗との差を係数として出します。[T.横浜店] は「新宿店と比べた横浜店の差」という意味です。
それぞれの係数は、ほかの説明変数の条件をそろえたうえでの効果です。たとえば広告費の0.84は、「同じ店舗・同じ曜日の種類どうしで比べたときの、広告費の効果」を表しています。
p値(P>|t|)
広告費のp値は 0.000 と表示されていて、0.001より小さいことがわかります。広告費は客数に有意な影響があるという結果になりました。詳しい値は、pvalues で確認できます。
model2.pvalues["ad_spend"]実行結果
np.float64(1.9280188211059472e-14)決定係数(R-squared)
| 項目 | 値 | 意味 |
|---|---|---|
| R-squared | 0.915 | 客数の変動の約92%を、このモデルで説明できている |
| Adj. R-squared | 0.914 | 説明変数の数を考慮して調整した決定係数。重回帰ではこちらを見る |
なぜ単回帰では効果が見えなかったのか
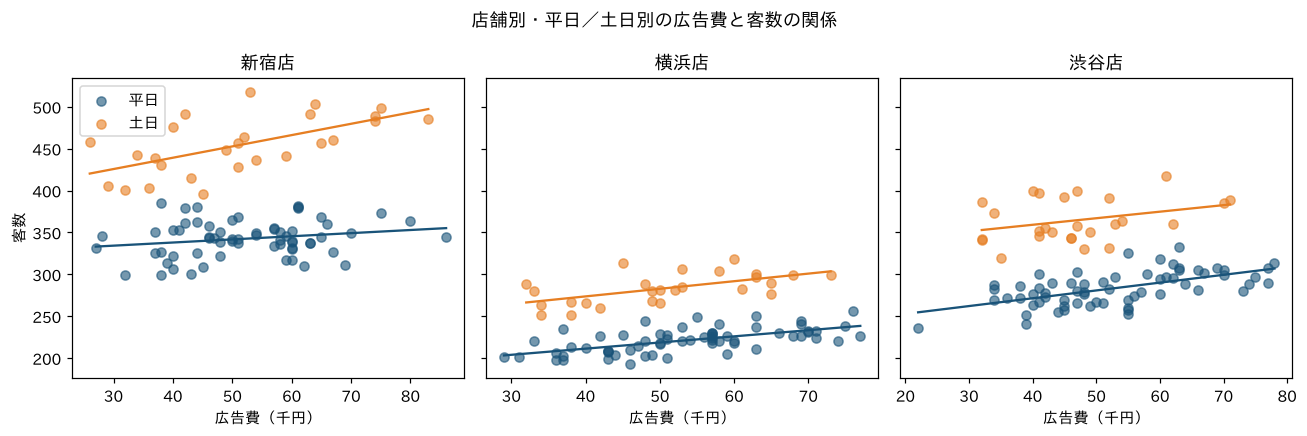
単回帰では、「店舗や曜日による客数の大きな違い」がすべて誤差として扱われ、広告費の効果がその中に埋もれていました。さらに、もし客の少ない店舗や平日に広告費を多くかけていたとすると、広告費と客数の関係は見かけ上弱くなってしまいます。
店舗別・平日/土日別に、広告費と客数の関係を描いてみましょう。
!pip install -q matplotlib-fontjaimport numpy as np
import matplotlib.pyplot as plt
import matplotlib_fontja
fig, axes = plt.subplots(1, 3, figsize=(12, 4), sharey=True)
for ax, (store, d) in zip(axes, daily.groupby("store")):
for wk, color, label in [(0, "#195379", "平日"), (1, "#E67E22", "土日")]:
g = d[d["weekend"] == wk]
ax.scatter(g["ad_spend"], g["customers"], color=color, alpha=0.6, label=label)
a, b = np.polyfit(g["ad_spend"], g["customers"], 1)
xs = np.linspace(g["ad_spend"].min(), g["ad_spend"].max(), 10)
ax.plot(xs, a * xs + b, color=color)
ax.set_title(store)
ax.set_xlabel("広告費(千円)")
axes[0].set_ylabel("客数")
axes[0].legend()
fig.suptitle("店舗別・平日/土日別の広告費と客数の関係")
plt.tight_layout()
plt.show()
条件をそろえると、どのグループでも右上がりの関係があることがわかります。重要な要因を入れずに分析すると、効果を見誤る──これは回帰分析で最も注意すべきポイントの1つです。
信頼区間を出す
係数は、データから推定した値なので、ある程度の幅があります。conf_int() で、係数の95%信頼区間を出せます。
model2.conf_int().round(2)実行結果
                      0       1
Intercept        294.24  317.75
C(store)[T.横浜店] -142.43 -130.11
C(store)[T.渋谷店]  -73.40  -61.08
ad_spend           0.63    1.04
weekend           82.22   93.40
広告費の係数は、0.63〜1.04の範囲にあると考えられます。「広告費を1,000円増やすと、客数は0.6〜1人くらい増える」と、幅を持って伝えるのが正確です。
predict()で予測する
作ったモデルで、条件を指定して客数を予測できます。渋谷店で、土日に広告費を6万円かけた場合の客数を予測してみましょう。
new = pd.DataFrame({"ad_spend": [60], "weekend": [1], "store": ["渋谷店"]})
model2.predict(new)
実行結果
0    376.799642
dtype: float64
約377人と予測されました。条件を複数並べれば、まとめて予測することもできます。
scikit-learnで回帰分析をするには
Pythonでは、機械学習のライブラリ scikit-learn でも回帰分析ができます。予測を重視するときに使われますが、p値や信頼区間は出せません。要因の影響を読み解きたいときは statsmodels、予測の精度を高めたいときは scikit-learn、と使い分けるのがおすすめです。
from sklearn.linear_model import LinearRegression

X = pd.get_dummies(daily[["ad_spend", "weekend", "store"]], columns=["store"], drop_first=True)
lr = LinearRegression().fit(X, daily["customers"])
pd.Series(lr.coef_, index=X.columns).round(2)
実行結果
ad_spend       0.84
weekend       87.81
store_横浜店   -136.27
store_渋谷店    -67.24
dtype: float64係数は、statsmodelsと同じ値になっています。pd.get_dummies() は、店舗の列を、0と1の列(ダミー変数)に変換する関数です。
回帰分析の注意点
- 重要な要因を入れ忘れない:今回のように、入れるべき変数が抜けていると結論が大きく変わります。
- 説明変数どうしが強く相関していると不安定になる:たとえば「テレビ広告費」と「Web広告費」をいつも同じ比率で使っていると、それぞれの効果を分けられません(多重共線性)。
- データの範囲外の予測は危険:広告費が最大でも数万円のデータで作ったモデルで、100万円かけたときの客数を予測しても、当たる保証はありません。
- 広告の効果は当日だけとは限らない:広告の効果は数日〜数週間続くことがあります。その影響を考慮する方法は、Pythonで広告の残存効果(アドストック)を計算する方法で解説しています。
まとめ
- 回帰分析は statsmodels の
smf.ols("目的変数 ~ 説明変数", data=データ).fit() - 係数は「その変数を1増やしたときの変化」、p値は有意かどうか、決定係数は説明力
- 文字の列は
C(列名)でグループとして扱う。基準のグループとの差が係数になる - 重要な要因を入れないと、効果を見誤ることがある
- 信頼区間は
conf_int()、予測はpredict()
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。