
Rで回帰分析をする方法【lm関数・単回帰と重回帰・結果の読み方】
 酒井 裕麻株式会社Bistro 代表取締役社長
「広告費を1,000円増やすと、客数は何人増えるのか?」──こうした問いに数字で答えてくれるのが回帰分析です。売上予測や広告効果の測定など、マーケティングの分析でもっともよく使われる手法の1つです。
この記事では、Rの lm() で回帰分析を行う方法と、結果の読み方を解説します。あわせて、ほかの要因を考えずに分析すると、広告の効果を見誤るという、実務でよくある落とし穴も紹介します。
参考記事
Rで相関分析をする方法【cor・cor.test・相関行列のヒートマップ】
Rで日付データを扱う方法【lubridateで変換・曜日・月初・週単位の集計】
Rで分散分析(ANOVA)をする方法【3つ以上のグループの平均を比べる】
回帰分析とは
回帰分析は、「結果(目的変数)」を「原因と考えられるもの(説明変数)」で説明する式を作る方法です。
客数 = 切片 + 係数 × 広告費
この「係数」が、広告費が1単位増えたときに客数がどれだけ増えるかを表します。説明変数が1つなら単回帰、複数なら重回帰と呼びます。
データの準備
売上データ(sales.csv)を、日付×店舗ごとの「客数」と「広告費(千円)」に集計し、土日かどうかを表す weekend 列(土日:1、平日:0)を作ります。
library(dplyr)
sales <- read.csv("sales.csv")
sales$date <- as.Date(sales$date)

daily <- sales %>%
  group_by(date, store) %>%
  summarise(customers = sum(customers), ad_spend = sum(ad_spend) / 1000) %>%
  mutate(weekend = ifelse(format(date, "%u") %in% c("6", "7"), 1, 0)) %>%
  ungroup()

head(daily, 3)
実行結果
# A tibble: 3 × 5
  date       store  customers ad_spend weekend
  <date>     <chr>      <int>    <dbl>   <dbl>
1 2026-01-01 新宿店       365       50       0
2 2026-01-01 横浜店       235       37       0
3 2026-01-01 渋谷店       253       55       0
format(date, "%u") は、曜日を「月曜=1 … 日曜=7」の数字で取り出す書き方です。
単回帰分析:広告費だけで客数を説明する
lm(目的変数 ~ 説明変数, data = データ) の形で書きます。
model1 <- lm(customers ~ ad_spend, data = daily)
summary(model1)
実行結果
Call:
lm(formula = customers ~ ad_spend, data = daily)

Residuals:
    Min      1Q  Median      3Q     Max
-111.93  -51.12  -10.19   42.08  210.58

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) 288.5742    18.6476   15.47   <2e-16 ***
ad_spend      0.3556     0.3487    1.02    0.309
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 71.51 on 268 degrees of freedom
Multiple R-squared:  0.003864,	Adjusted R-squared:  0.0001474
F-statistic: 1.04 on 1 and 268 DF, p-value: 0.3088広告費の係数は0.36ですが、p値(Pr(>|t|))は0.309で有意ではありません。決定係数(R-squared)も0.004と、客数の変動をほとんど説明できていません。
この結果だけを見ると、「広告には効果がない」と結論づけてしまいそうです。
重回帰分析:曜日と店舗も考慮する
しかし、客数は広告費以外にも、曜日(土日は客が多い)や店舗(店舗ごとに規模が違う)の影響を大きく受けます。これらを説明変数に加えて、重回帰分析をしてみましょう。説明変数は + でつなぎます。
model2 <- lm(customers ~ ad_spend + weekend + store, data = daily)
summary(model2)
実行結果
Call:
lm(formula = customers ~ ad_spend + weekend + store, data = daily)

Residuals:
    Min      1Q  Median      3Q     Max
-52.766 -14.354   0.311  12.683  79.821

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept)  305.9930     5.9705  51.251  < 2e-16 ***
ad_spend       0.8373     0.1033   8.107 1.93e-14 ***
weekend       87.8095     2.8397  30.922  < 2e-16 ***
store横浜店 -136.2690     3.1293 -43.547  < 2e-16 ***
store渋谷店  -67.2405     3.1303 -21.480  < 2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 20.99 on 265 degrees of freedom
Multiple R-squared:  0.9151,	Adjusted R-squared:  0.9139
F-statistic: 714.5 on 4 and 265 DF,  p-value: < 2.2e-16
結果が大きく変わりました。
結果の読み方
係数(Estimate)
| 説明変数 | 係数 | 読み方 |
|---|---|---|
| ad_spend | 0.84 | 広告費を1,000円増やすと、客数が約0.84人増える |
| weekend | 87.81 | 土日は平日より約88人多い |
| store横浜店 | -136.27 | 横浜店は新宿店より約136人少ない |
| store渋谷店 | -67.24 | 渋谷店は新宿店より約67人少ない |
店舗のような文字の列を入れると、Rは自動的に1つの店舗を基準(ここでは五十音順で最初の「新宿店」)にして、ほかの店舗との差を係数として出します。
それぞれの係数は、ほかの説明変数の条件をそろえたうえでの効果です。たとえば広告費の0.84は、「同じ店舗・同じ曜日の種類どうしで比べたときの、広告費の効果」を表しています。
p値(Pr(>|t|))
広告費のp値は 1.93e-14 と非常に小さくなり、広告費は客数に有意な影響があるという結果になりました。
決定係数(R-squared)
| 指標 | 値 | 意味 |
|---|---|---|
| Multiple R-squared | 0.9151 | 客数の変動の約92%を、このモデルで説明できている |
| Adjusted R-squared | 0.9139 | 説明変数の数を考慮して調整した決定係数。重回帰ではこちらを見る |
単回帰の0.004から、0.91まで大きく改善しました。
なぜ単回帰では効果が見えなかったのか
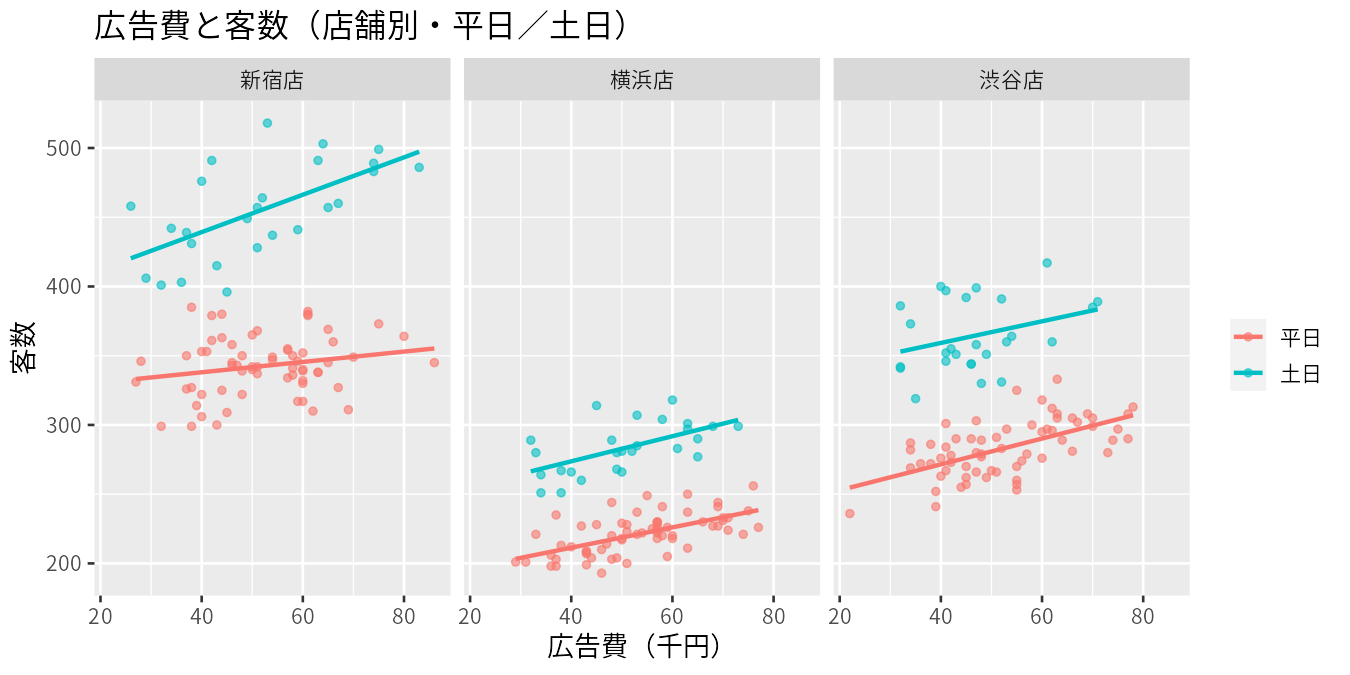
単回帰では、「店舗や曜日による客数の大きな違い」がすべて誤差として扱われ、広告費の効果がその中に埋もれていました。さらに、もし客の少ない店舗や平日に広告費を多くかけていたとすると、広告費と客数の関係は見かけ上弱くなってしまいます。
記事の冒頭のグラフは、店舗別・平日/土日別に広告費と客数の関係を描いたものです。条件をそろえると、どのグループでも右上がりの関係があることがわかります。重要な要因を入れずに分析すると、効果を見誤る──これは回帰分析で最も注意すべきポイントの1つです。
信頼区間を出す
係数がどのくらいの範囲にありそうかは、confint() で確認できます。
round(confint(model2), 2) 2.5 % 97.5 %
(Intercept) 294.24 317.75
ad_spend 0.63 1.04
weekend 82.22 93.40
store横浜店 -142.43 -130.11
store渋谷店 -73.40 -61.08広告費1,000円あたりの効果は、0.63〜1.04人の範囲にあると考えられます。
predict()で予測する
作ったモデルを使って、「渋谷店で、土曜日に広告費を6万円かけたら、客数は何人になるか」を予測してみます。
new <- data.frame(ad_spend = 60, weekend = 1, store = "渋谷店")
predict(model2, newdata = new)
実行結果
       1
376.7996
約377人と予測されました。計算の中身は、305.99 + 0.8373×60 + 87.81 − 67.24 ≒ 376.8 です。
回帰分析の注意点
- 重要な要因を入れ忘れない:今回のように、入れるべき変数が抜けていると結論が大きく変わります。
- 説明変数どうしが強く相関していると不安定になる:たとえば「テレビ広告費」と「Web広告費」をいつも同じ比率で使っていると、それぞれの効果を分けられません(多重共線性)。
- データの範囲外の予測は危険:広告費が最大でも数万円のデータで作ったモデルで、100万円かけたときの客数を予測しても、当たる保証はありません。
- 広告の効果は当日だけとは限らない:広告の効果は数日〜数週間続くことがあります。その影響を考慮する方法は、アドストックの記事で解説します。
まとめ
lm(目的変数 ~ 説明変数1 + 説明変数2, data = データ)で回帰分析ができるsummary()で、係数(効果の大きさ)・p値(有意かどうか)・決定係数(説明力)を確認する- 文字の列は、基準のグループとの差として係数が出る
- 重要な要因を入れないと、効果を見誤ることがある
predict()で、条件を指定して予測ができる
回帰分析は、広告効果の測定やマーケティング・ミックス・モデリング(MMM)の土台にもなっている手法です。まずは身近なデータで、いろいろな説明変数を試してみてください。
同じことをGoogle ColabのPythonで行う方法は、Pythonで回帰分析をする方法【statsmodelsのols・単回帰と重回帰・結果の読み方】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。