
Rで相関分析をする方法【cor・cor.test・相関行列のヒートマップ】
 酒井 裕麻株式会社Bistro 代表取締役社長
「価格に満足している人ほど、商品全体の満足度も高いのか?」──こうした2つの項目の関係の強さを数字で表すのが相関分析です。
この記事では、Rで相関係数を出す方法、その相関が偶然ではないかを確かめる検定、たくさんの項目の相関をまとめて見るヒートマップの作り方を解説します。
参考記事
Rで基本統計量とクロス集計を出す方法【summary・table・prop.table】
Rでヒストグラムと箱ひげ図を作る方法【データの分布・外れ値の見方】
ggplot2でグラフを作る方法【棒・折れ線・散布図と日本語の文字化け対策】
相関係数とは
相関係数は、2つの項目が「一緒に増える・減る」関係の強さを、-1〜1の数字で表したものです。
| 相関係数 | 関係 | 目安 |
|---|---|---|
| 1に近い | 一方が大きいほど、もう一方も大きい(正の相関) | 0.7以上:強い 0.4〜0.7:中程度 |
| 0に近い | 関係がほとんどない | -0.2〜0.2:ほぼ無相関 |
| -1に近い | 一方が大きいほど、もう一方は小さい(負の相関) | -0.4以下:中程度以上の負の相関 |
※目安は分野によって異なります。
この記事で使うデータ
架空の商品アンケート survey.csv(400人分)を使います。
survey <- read.csv("survey.csv")| 列名 | 内容 |
|---|---|
| awareness | 商品の認知度(1〜5) |
| price_sat | 価格への満足度(1〜5) |
| ad_contact | 広告を見たか(1:見た、0:見ていない) |
| purchase | 購入したか(1:購入、0:非購入) |
| satisfaction | 総合満足度(0〜10) |
cor()で相関係数を出す
価格満足度と総合満足度の相関係数を出します。
cor(survey$price_sat, survey$satisfaction)実行結果
[1] 0.4698775相関係数は約0.47で、中程度の正の相関があります。価格に満足している人ほど、総合満足度も高い傾向がある、と読み取れます。
散布図にすると、右上がりの傾向が確認できます。
library(ggplot2)
theme_set(theme_gray(base_family = "Meiryo"))  # Macは "Hiragino Sans"

ggplot(survey, aes(x = price_sat, y = satisfaction)) +
  geom_jitter(width = 0.2, height = 0.2, alpha = 0.4, color = "#195379") +
  geom_smooth(method = "lm", se = FALSE, color = "#C2410C") +
  labs(title = "価格満足度と総合満足度", x = "価格満足度(1〜5)", y = "総合満足度(0〜10)")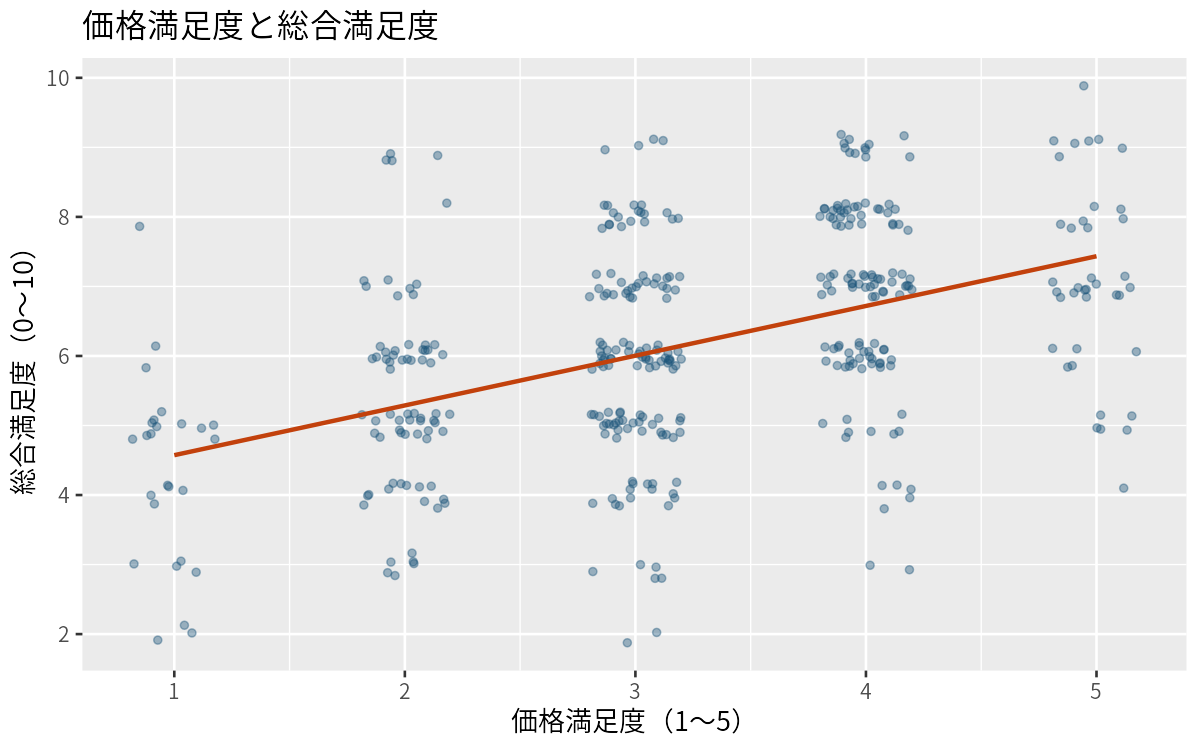
アンケートの点数のような整数のデータは、そのまま散布図にすると点がぴったり重なってしまいます。geom_jitter() は、点を少しだけランダムにずらして重なりを見やすくする関数です。
cor.test()で相関の検定をする
相関係数が0.47と出ても、たまたまそうなっただけかもしれません。「本当は相関がない(相関係数が0)」と仮定して、今回の結果がどれくらい起こりにくいかを確かめるのが cor.test() です。
cor.test(survey$price_sat, survey$satisfaction)実行結果
	Pearson's product-moment correlation

data:  survey$price_sat and survey$satisfaction
t = 10.619, df = 398, p-value < 2.2e-16
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.3897840 0.5429158
sample estimates:
      cor
0.4698775 | 項目 | 読み方 |
|---|---|
| p-value | 2.2e-16(0.00000…)より小さく、0.05を大きく下回る。偶然とは考えにくく、相関がある |
| 95 percent confidence interval | 本当の相関係数は、0.39〜0.54の範囲にあると考えられる |
| cor | 相関係数(0.47) |
一般に、p値が0.05より小さければ「統計的に有意」と判断します。
相関行列:たくさんの項目をまとめて見る
cor() にデータフレームを渡すと、すべての項目の組み合わせの相関係数(相関行列)が一度に出せます。表を読みやすくするため、列名を日本語にしておきます。
vars <- survey[, c("awareness", "price_sat", "ad_contact", "purchase", "satisfaction")]
names(vars) <- c("認知度", "価格満足度", "広告接触", "購入", "総合満足度")
round(cor(vars), 2)
実行結果
           認知度 価格満足度 広告接触 購入 総合満足度
認知度       1.00      -0.04     0.09 0.22       0.28
価格満足度  -0.04       1.00     0.00 0.20       0.47
広告接触     0.09       0.00     1.00 0.24       0.05
購入         0.22       0.20     0.24 1.00       0.18
総合満足度   0.28       0.47     0.05 0.18       1.00
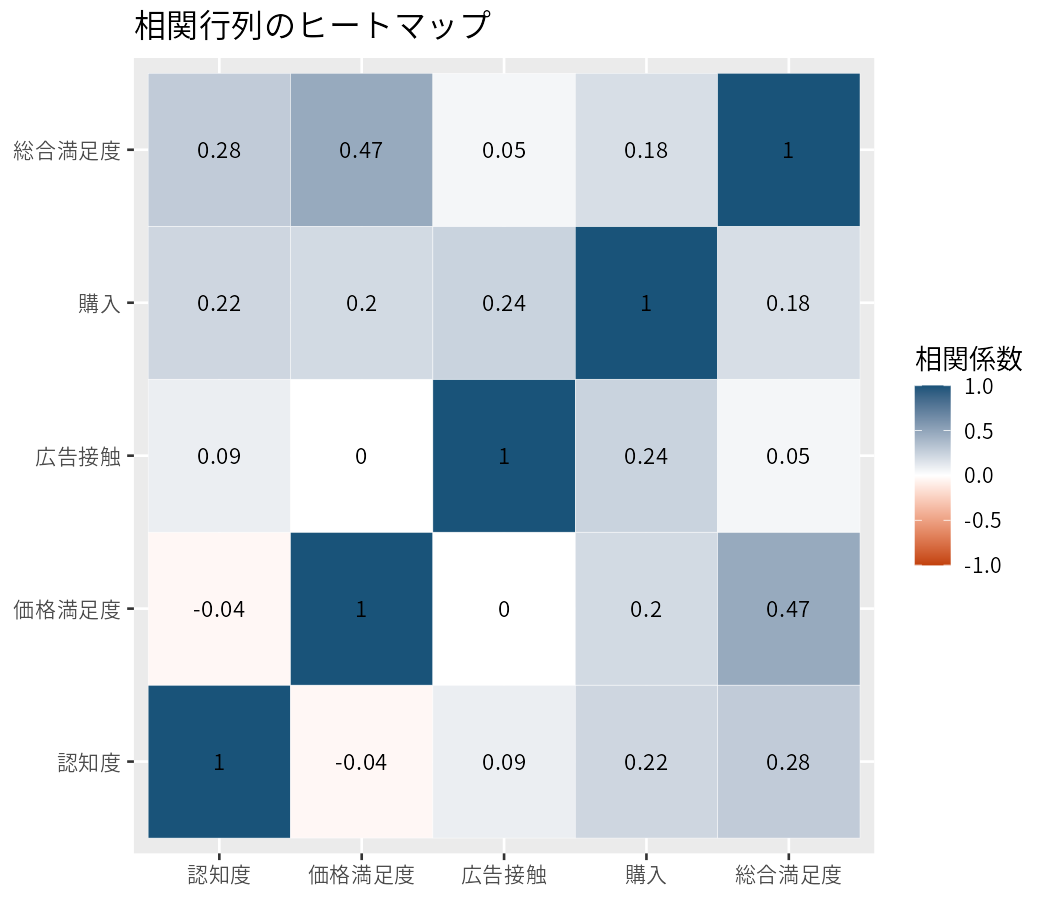
「購入」の行を見ると、広告接触(0.24)・認知度(0.22)・価格満足度(0.20)と、いずれも弱い正の相関があります。一方、総合満足度に強く関係しているのは価格満足度(0.47)で、広告接触(0.05)とはほぼ関係がありません。
※購入(0/1)や広告接触(0/1)のような2択のデータでも相関係数は計算できますが、影響の大きさをきちんと比べたいときは、ロジスティック回帰分析を使うのがおすすめです。
ヒートマップで見やすくする
項目が多くなると、数字の表だけでは読み取りにくくなります。色の濃さで相関を表すヒートマップにすると、関係の強い組み合わせがひと目でわかります。記事の冒頭の図は、次のコードで作りました。
cm <- round(cor(vars), 2)
cm_long <- as.data.frame(as.table(cm))  # ggplot2用に縦持ちにする

ggplot(cm_long, aes(Var1, Var2, fill = Freq)) +
  geom_tile(color = "white") +
  geom_text(aes(label = Freq)) +
  scale_fill_gradient2(low = "#C2410C", mid = "white", high = "#195379", limits = c(-1, 1)) +
  labs(title = "相関行列のヒートマップ", x = NULL, y = NULL, fill = "相関係数")
scale_fill_gradient2() で、負の相関をオレンジ、0を白、正の相関を青に塗り分けています。
順位相関(スピアマン)
アンケートの5段階評価のような順序のあるデータや、外れ値の多いデータでは、値そのものではなく順位で相関を測るスピアマンの順位相関係数もよく使われます。
cor(vars, method = "spearman")["価格満足度", "総合満足度"][1] 0.4769495今回は通常の相関係数(0.47)とほぼ同じ値になりました。2つの値が大きく違う場合は、外れ値や、直線的ではない関係がないかを散布図で確認しましょう。
相関分析の注意点
- 相関関係は因果関係ではない:「価格満足度が上がれば、総合満足度が上がる」とまでは言えません。品質の良さが両方を押し上げている、といった別の要因の可能性もあります。
- 直線的な関係しか測れない:U字型のような関係は、相関係数が0に近くなってしまいます。必ず散布図も確認しましょう。
- 外れ値に弱い:極端な値が1つあるだけで、相関係数が大きく変わることがあります。
まとめ
cor()で相関係数(-1〜1)を出すcor.test()で、その相関が偶然ではないかを検定する(p値 < 0.05 で有意)- データフレームを
cor()に渡すと相関行列、ヒートマップにすると見やすい - 順序データや外れ値が多いときは
method = "spearman" - 相関は因果ではない。散布図とセットで確認する
相関分析は、「どの項目とどの項目が関係していそうか」のあたりをつけるのに最適です。気になる関係が見つかったら、回帰分析などでさらに深掘りしていきましょう。
同じことをGoogle ColabのPythonで行う方法は、Pythonで相関分析をする方法【corr・pearsonr・相関行列のヒートマップ】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。