
Rでアンケートの自由回答をテキストマイニングする方法【RMeCabで頻出語・満足度別の比較】
 酒井 裕麻株式会社Bistro 代表取締役社長
アンケートの自由回答には、選択式の設問ではわからないお客様の生の声が詰まっています。ただ、回答が数百件になると、すべてを読んで傾向をまとめるのは大変です。
そこで役立つのがテキストマイニングです。文章を単語に分けて数えることで、「どんな言葉がよく出てくるか」「満足している人と不満のある人で、何が違うか」をデータで把握できます。この記事では、Rの RMeCab パッケージを使って、自由回答を分析する方法を解説します。
参考記事
アンケート調査の分析の進め方【設計から集計・レポートまでの7ステップ】
Rで満足度のドライバー分析をする方法【重回帰で改善の優先順位を決める】
dplyrでデータ加工入門【filter・select・mutate・group_by・summarise】
日本語のテキストマイニングには「形態素解析」が必要
英語は単語と単語の間にスペースがありますが、日本語にはありません。そのため、まず文章を単語に分ける形態素解析という処理が必要です。
形態素解析には、MeCab(メカブ) という無料のソフトがよく使われます。RからMeCabを使うためのパッケージが RMeCab です。
MeCabとRMeCabのインストール
- MeCabをインストールする
- Windows:MeCabの公式サイトからインストーラーをダウンロードし、インストール時の文字コードで「UTF-8」を選びます
- Mac:ターミナルで
brew install mecab mecab-ipadicを実行します(Homebrewが必要です)
- RMeCabをインストールする:Rで次のコマンドを実行します
install.packages("RMeCab", repos = "https://rmecab.jp/R")インストールできたか、簡単な文で試してみましょう。
library(RMeCab)
unlist(RMeCabC("今日はとても良い天気です"))
実行結果
    名詞     助詞     副詞   形容詞     名詞   助動詞
"今日" "は" "とても" "良い" "天気" "です" 文章が単語に分かれ、それぞれの品詞(名詞・助詞・形容詞など)が付きました。
この記事で使うデータ
飲食店のアンケート(架空・300人分)の、総合満足度(0〜10点)と自由回答 free_answers.csv を使います。
library(dplyr)
library(purrr)
library(stringr)
library(ggplot2)
theme_set(theme_gray(base_family = "Meiryo"))  # Macは "Hiragino Sans"

fa <- read.csv("free_answers.csv", fileEncoding = "UTF-8")
head(fa, 3)
実行結果
  id satisfaction                                                            comment
1  1            6       デザートがおいしくてまた来たいです。量の割に値段が高いと思います。
2  2            7 季節のメニューが楽しみです。料理が出てくるまでの待ち時間が長かったです。
3  3            9         店員さんの笑顔が素敵でした。予約の電話がつながりにくかったです。
手順1:すべての回答を単語に分ける
RMeCabC() の2つ目の引数を 1 にすると、単語が基本形(「おいしかった」→「おいしい」)になります。活用の違いをまとめて数えられるので、集計にはこちらが便利です。
unlist(RMeCabC(fa$comment[1], 1)) 名詞 助詞 形容詞 助詞 副詞 動詞 助動詞
"デザート" "が" "おいしい" "て" "また" "来る" "たい"
助動詞 記号 名詞 助詞 名詞 助詞 名詞
"です" "。" "量" "の" "割" "に" "値段"
助詞 形容詞 助詞 動詞 助動詞 記号
"が" "高い" "と" "思う" "ます" "。" 300件すべての回答を単語に分け、「回答ID・単語・品詞」の表にまとめます。
tok <- map_dfr(seq_len(nrow(fa)), function(i) {
  x <- unlist(RMeCabC(fa$comment[i], 1))
  data.frame(id = fa$id[i], word = unname(x), pos = names(x))
})
head(tok, 8)
実行結果
  id     word    pos
1  1 デザート   名詞
2  1       が   助詞
3  1 おいしい 形容詞
4  1       て   助詞
5  1     また   副詞
6  1     来る   動詞
7  1     たい 助動詞
8  1     です 助動詞
手順2:意味のある言葉だけを残す
助詞(が・は・の)や助動詞(です・ます)は、どの回答にも出てくるので、分析の役に立ちません。名詞・形容詞・動詞だけを残し、「する」「ある」のような、どの文にも出てくる言葉(ストップワード)も除きます。
stop <- c("する", "ある", "いる", "なる", "来る", "くる", "思う", "にくい",
          "の", "さん", "こと", "もう少し", "少し", "ちょうど", "とても")

words <- tok %>%
  filter(pos %in% c("名詞", "形容詞", "動詞"), !word %in% stop)
ストップワードは、データを見ながら少しずつ追加していくのが一般的です。
手順3:よく出てくる言葉を数える
1つの回答に同じ言葉が何度出てきても1回と数えるように、distinct() で重複を除いてから数えます。これで「その言葉が出てきた回答の数」になります。
freq <- words %>%
  distinct(id, word, pos) %>%
  count(word, pos, sort = TRUE)
head(freq, 15)
実行結果
       word    pos  n
1      料理   名詞 93
2  おいしい 形容詞 60
3    雰囲気   名詞 54
4      店員   名詞 51
5        量   名詞 48
6      値段   名詞 44
7      高い 形容詞 44
8    ランチ   名詞 42
9  待ち時間   名詞 37
10     長い 形容詞 37
11 メニュー   名詞 31
12     季節   名詞 31
13   楽しみ   名詞 31
14     笑顔   名詞 31
15 素敵 名詞 31ggplot(head(freq, 15), aes(reorder(word, n), n)) +
geom_col(fill = "#195379", width = 0.7) +
coord_flip() +
labs(title = "自由回答によく出てくる言葉(上位15語)", x = NULL, y = "出てきた回答の数")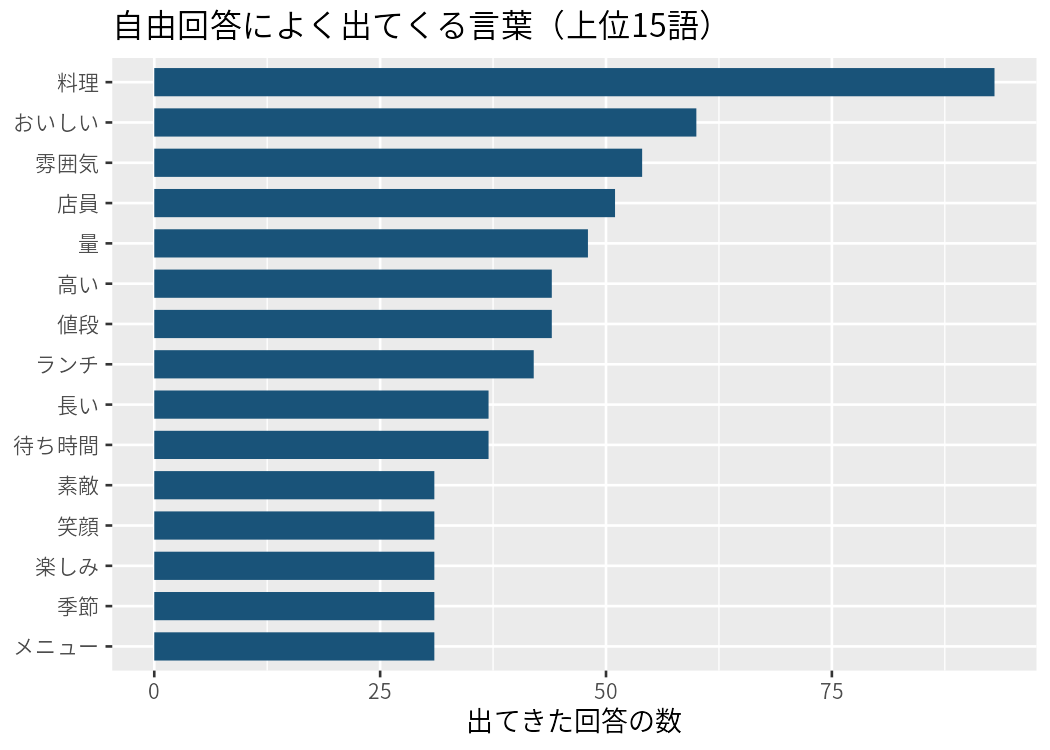
「料理」「おいしい」が多い一方で、「値段」「高い」「待ち時間」「長い」もよく出てきます。ただし、これだけでは良い意味で使われているのか、不満として使われているのかがわかりません。
手順4:満足度の高い人と低い人で比べる
総合満足度で回答者を「高満足(8〜10点)」と「低満足(3〜5点)」に分け、それぞれのグループでその言葉が出てきた回答の割合を比べます。
fa$group <- case_when(
  fa$satisfaction >= 8 ~ "high",
  fa$satisfaction <= 5 ~ "low",
  TRUE ~ "middle"
)
table(fa$group)

n_group <- table(fa$group)
cmp <- words %>%
  distinct(id, word) %>%
  inner_join(fa[, c("id", "group")], by = "id") %>%
  filter(group != "middle") %>%
  count(group, word) %>%
  mutate(rate = n / as.numeric(n_group[group]) * 100) %>%
  select(group, word, rate) %>%
  tidyr::pivot_wider(names_from = group, values_from = rate, values_fill = 0) %>%
  mutate(diff = high - low) %>%
  arrange(desc(diff))

head(cmp, 8)
tail(cmp, 8)
実行結果
  high    low middle
   122     64    114

# A tibble: 8 × 4
  word      high   low  diff
  <chr>    <dbl> <dbl> <dbl>
1 おいしい  30.3  4.69  25.6
2 雰囲気    26.2  4.69  21.5
3 笑顔      17.2  1.56  15.7
4 素敵      17.2  1.56  15.7
5 よい      16.4  3.12  13.3
6 デザート  14.8  1.56  13.2
7 セット    13.1  0     13.1
8 得        13.1  0     13.1

# A tibble: 8 × 4
  word      high   low  diff
  <chr>    <dbl> <dbl> <dbl>
1 昼       2.46   15.6 -13.2
2 時間     2.46   15.6 -13.2
3 出る     0.820  14.1 -13.2
4 つながる 2.46   20.3 -17.9
5 予約     2.46   20.3 -17.9
6 電話     2.46   20.3 -17.9
7 待ち時間 3.28   28.1 -24.8
8 長い     3.28   28.1 -24.8
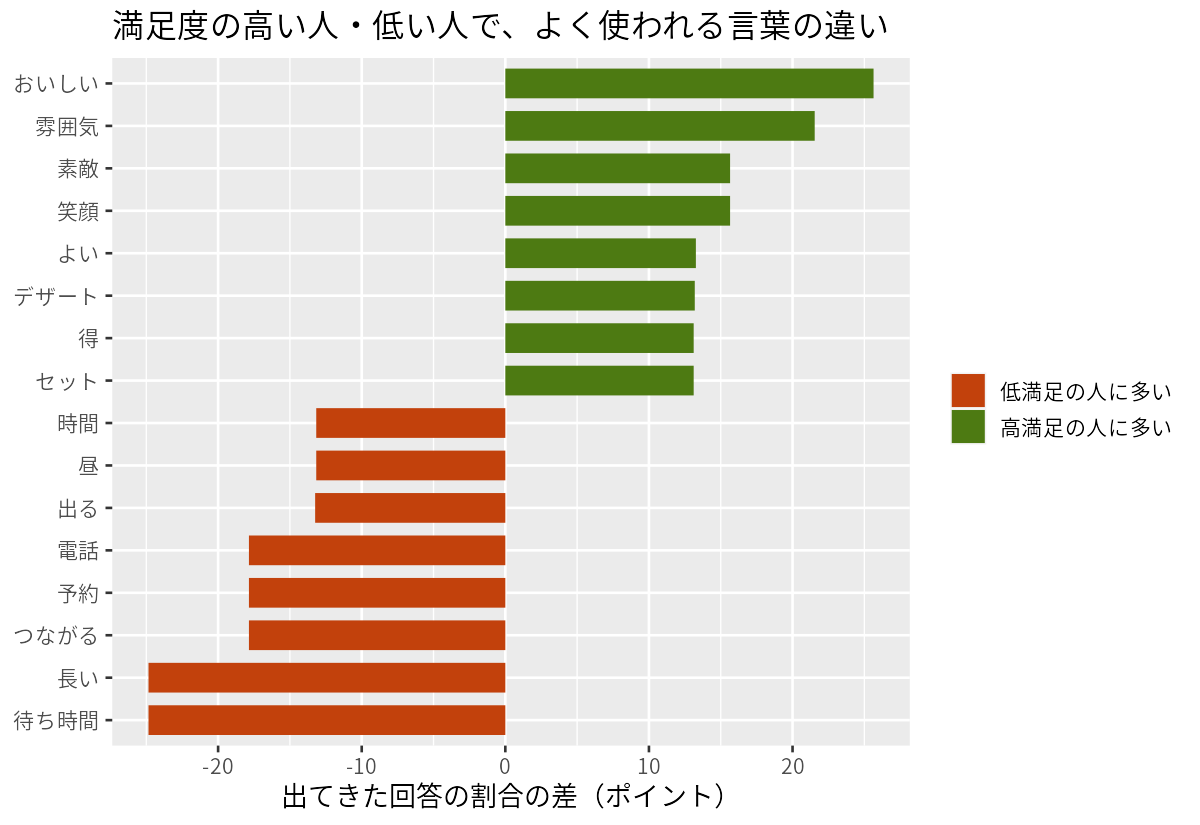
記事の冒頭のグラフは、この差(ポイント)を棒グラフにしたものです。
- 満足度の高い人:「おいしい」「雰囲気」「笑顔」「素敵」「デザート」「セット」「得」→ 料理の味・雰囲気・接客・ランチセットのお得感が評価されている
- 満足度の低い人:「待ち時間」「長い」「予約」「電話」「つながる」「昼」→ 料理が出るまでの待ち時間、特に昼の時間帯と、予約の電話がつながりにくいことが不満の中心
単語の頻度だけでは見えなかった「良い評価」と「不満」が、満足度と組み合わせることで、はっきり分かれて見えてきました。
手順5:元の文章を読んで確かめる
テキストマイニングで気になる言葉が見つかったら、その言葉を含む元の回答を読んで、どんな文脈で使われているかを必ず確かめます。
head(fa$comment[str_detect(fa$comment, "待ち時間")], 3)[1] "季節のメニューが楽しみです。料理が出てくるまでの待ち時間が長かったです。"
[2] "料理がとてもおいしかったです。昼の時間は待ち時間が長くて困りました。"
[3] "料理が出てくるまでの待ち時間が長かったです。"数字で傾向をつかみ、実際の文章で中身を確かめる──この行き来が、テキストマイニングをレポートに活かすコツです。
テキストマイニングの注意点
- 同じ意味の言葉をまとめる:「値段」「価格」「料金」のように、同じ意味の言葉は置き換えてから数えると、傾向がはっきりします
- 否定の言葉に気をつける:「おいしくない」は「おいしい」と「ない」に分かれます。形容詞だけを数えると、意味が逆になることがあります
- 新しい言葉や固有名詞:商品名やサービス名は、MeCabの辞書にないと細かく分かれてしまいます。ユーザー辞書に登録すると、1つの単語として扱えます
- 最後は人が読む:テキストマイニングは、大量の回答から「読むべき回答」を見つけるための道具です
まとめ
- 日本語のテキストマイニングには、MeCab(RではRMeCab)で単語に分ける形態素解析が必要
- 名詞・形容詞・動詞を残し、ストップワードを除いてから数える
- 同じ回答の中の重複を除いて、「その言葉が出てきた回答の数」で比べる
- 満足度などの選択式の回答と組み合わせると、評価されている点と不満の点が分かれて見える
- 気になる言葉は、必ず元の文章で文脈を確かめる
自由回答は、集計しにくいからと読み流されがちですが、テキストマイニングを使えば、選択式の設問では拾えない改善のヒントを効率よく見つけられます。
同じことをGoogle ColabのPythonで行う方法は、Pythonでアンケートの自由回答をテキストマイニングする方法【janomeで頻出語・満足度別の比較】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。