
Rで主成分分析(PCA)をする方法【prcompの使い方と結果の読み方】
 酒井 裕麻株式会社Bistro 代表取締役社長
アンケートで「味」「香り」「見た目」「価格」「量」「入手しやすさ」と6つの項目を聞いたとき、項目が多すぎて全体像がつかみにくい、と感じたことはないでしょうか。
主成分分析(PCA)は、たくさんの項目を、情報をなるべく失わずに少数の「総合的な指標」にまとめる方法です。この記事では、Rの prcomp() で主成分分析を行う方法と、結果の読み方を解説します。
参考記事
Rで相関分析をする方法【cor・cor.test・相関行列のヒートマップ】
Rでk-means法のクラスター分析をする方法【顧客セグメンテーション入門】
主成分分析とは
たとえば「味」「香り」「見た目」の評価は、互いに似た動きをしがちです(味の評価が高い人は、香りの評価も高い)。こうした一緒に動く項目をまとめて、1つの軸にするのが主成分分析の考え方です。
まとめてできた新しい軸を主成分と呼び、データのばらつきを最も多く説明する軸から順に、第1主成分、第2主成分…となります。
この記事で使うデータ
架空の商品評価アンケート product_eval.csv(200人分、各項目1〜5点程度)を使います。
ev <- read.csv("product_eval.csv")
head(ev, 3)
実行結果
   味 香り 見た目 価格  量 入手しやすさ
1 4.9  4.1    4.5  5.4 4.7          4.7
2 2.5  2.1    1.9  3.4 3.7          3.9
3 2.1  2.2    1.6  3.1 2.7          3.9
prcomp()で主成分分析をする
pca <- prcomp(ev, scale. = TRUE)
summary(pca)
scale. = TRUE は、各項目を標準化(平均0・標準偏差1にそろえる)してから分析する指定です。単位や点数の幅が違う項目を扱うときは、必ず付けておきましょう。
実行結果
Importance of components:
                          PC1    PC2     PC3     PC4     PC5     PC6
Standard deviation     1.5121 1.4585 0.77319 0.67268 0.53089 0.50434
Proportion of Variance 0.3811 0.3545 0.09964 0.07542 0.04697 0.04239
Cumulative Proportion 0.3811 0.7356 0.83522 0.91063 0.95761 1.00000| 項目 | 意味 |
|---|---|
| Proportion of Variance | 寄与率。その主成分が、元のデータの情報(ばらつき)を何%説明しているか |
| Cumulative Proportion | 累積寄与率。第1主成分からその主成分までで、合計何%を説明しているか |
第1主成分(PC1)が38.1%、第2主成分(PC2)が35.5%で、この2つだけで6項目の情報の73.6%を説明できています。6つの項目を、2つの軸に要約できたことになります。
主成分はいくつ使えばいい?
よく使われる目安は次のとおりです。
- 累積寄与率が70〜80%を超えるところまで
- 標準偏差(Standard deviation)が1以上の主成分まで
今回はどちらの目安でも、第2主成分まで使えばよさそうです。PC3からは寄与率が10%を下回り、一気に小さくなっています。
主成分負荷量で、軸の意味を読み取る
それぞれの主成分が「何を表す軸なのか」は、主成分負荷量(rotation)を見て解釈します。
round(pca$rotation[, 1:2], 3)実行結果
                PC1    PC2
味           -0.585  0.006
香り         -0.591  0.013
見た目       -0.545  0.046
価格         -0.095 -0.597
量           -0.004 -0.615
入手しやすさ 0.044 -0.513| 主成分 | 大きく関係している項目 | 解釈 |
|---|---|---|
| PC1 | 味・香り・見た目 | 「おいしさ・品質」の軸 |
| PC2 | 価格・量・入手しやすさ | 「お得さ・手軽さ」の軸 |
数字の絶対値が大きい項目ほど、その主成分と強く関係しています。今回はどちらもマイナスの値が大きいので、「PC1が小さい(マイナス)ほど品質の評価が高い」という向きになります。
※主成分の符号(プラス・マイナス)は計算の都合で決まるもので、それ自体に意味はありません。わかりにくいときは、符号を反転させて解釈してもかまいません。
主成分得点
一人ひとりの回答者が、それぞれの軸でどのあたりに位置するかは、主成分得点(x)で確認できます。
scores <- as.data.frame(pca$x[, 1:2])
head(round(scores, 2), 3)
PC1 PC2
1 -2.69 -3.22
2 1.63 -1.26
3 2.02 -0.481人目はPC1・PC2ともに大きなマイナスで、品質もお得さも高く評価している人だとわかります。この得点を使って、k-means法などで回答者をグループ分けすることもできます。
バイプロットで見える化する
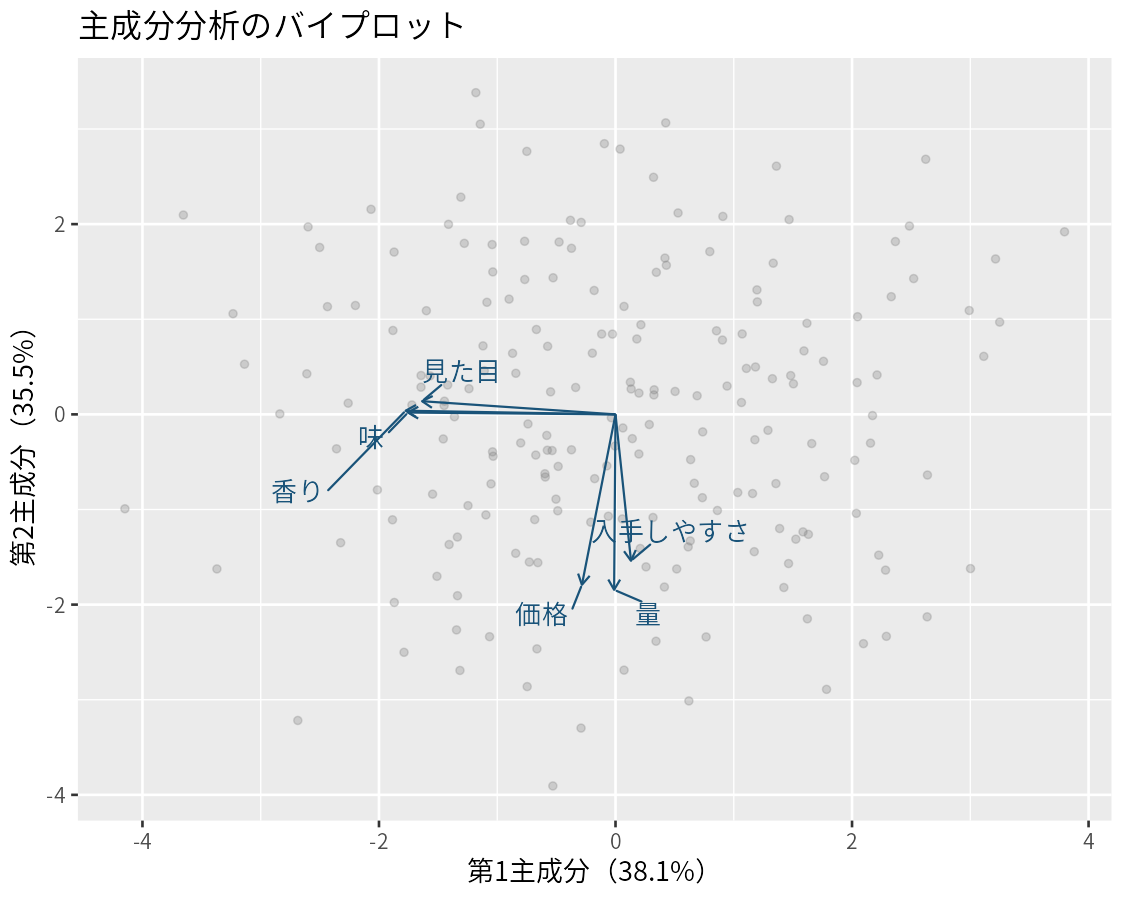
主成分得点(点)と主成分負荷量(矢印)を1枚の図に重ねたのがバイプロットです。手早く確認するなら、Rに標準で入っている biplot() が使えます。
biplot(pca)記事の冒頭の図は、ggplot2で見やすく描いたものです(矢印のラベルの重なりを避けるため、ggrepelパッケージを使っています)。
library(ggplot2)
library(ggrepel)
theme_set(theme_gray(base_family = "Meiryo"))  # Macは "Hiragino Sans"

load <- as.data.frame(pca$rotation[, 1:2])
load$var <- rownames(load)
imp <- round(summary(pca)$importance[2, 1:2] * 100, 1)

ggplot() +
  geom_point(data = scores, aes(PC1, PC2), alpha = 0.3, color = "grey50") +
  geom_segment(data = load, aes(x = 0, y = 0, xend = PC1 * 3, yend = PC2 * 3),
               arrow = arrow(length = unit(0.2, "cm")), color = "#195379") +
  geom_text_repel(data = load, aes(PC1 * 3, PC2 * 3, label = var),
                  color = "#195379", size = 4.5, box.padding = 0.6, seed = 1) +
  labs(title = "主成分分析のバイプロット",
       x = paste0("第1主成分(", imp[1], "%)"), y = paste0("第2主成分(", imp[2], "%)"))
矢印は、それぞれの項目がどの方向に効いているかを表します。「味・香り・見た目」の矢印は左(PC1の方向)へ、「価格・量・入手しやすさ」の矢印は下(PC2の方向)へ伸びていて、6つの項目がきれいに2つのグループに分かれていることがわかります。
※負荷量の矢印は、見やすくするために3倍の長さで描いています。
主成分分析を使う場面
- アンケートの多くの項目を、少数の評価軸にまとめる
- ブランドや商品のポジショニングマップを作る(主成分得点を商品ごとに平均して、2次元の地図に配置する)
- 回帰分析の前に、互いに似た説明変数をまとめる(多重共線性の対策)
まとめ
prcomp(データ, scale. = TRUE)で主成分分析ができるsummary()の寄与率で、各主成分がどれだけ情報を説明しているかを確認するrotation(主成分負荷量)を見て、それぞれの軸の意味を解釈するx(主成分得点)で、一人ひとりの位置がわかる- バイプロットで、項目と回答者の関係を1枚の図で見える化できる
項目が多くて全体像が見えないときは、まず主成分分析で「データの軸」を見つけるところから始めてみましょう。
同じことをGoogle ColabのPythonで行う方法は、Pythonで主成分分析(PCA)をする方法【scikit-learnの使い方と結果の読み方】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。