
Rでk-means法のクラスター分析をする方法【顧客セグメンテーション入門】
 酒井 裕麻株式会社Bistro 代表取締役社長
「よく来るけれど単価は低いお客さま」「たまにしか来ないけれど、来ると高額な買い物をするお客さま」──顧客をこうした似たもの同士のグループに分けることを顧客セグメンテーションと呼びます。
この記事では、セグメンテーションでよく使われる k-means法(クラスター分析の一種)を、Rの kmeans() で行う方法を解説します。
参考記事
ggplot2でグラフを作る方法【棒・折れ線・散布図と日本語の文字化け対策】
dplyrでデータ加工入門【filter・select・mutate・group_by・summarise】
Rで決定木分析をする方法【rpartで購入者の特徴をルール化する】
k-means法とは
k-means法は、データをあらかじめ決めたk個のグループ(クラスター)に分ける方法です。
- k個の「中心」をランダムに置く
- それぞれのデータを、いちばん近い中心のグループに入れる
- グループごとに平均を取り、そこを新しい中心にする
- 中心が動かなくなるまで2と3を繰り返す
「答え(正解のグループ)」を与えずに、データの似かたからグループを見つけるので、教師なし学習とも呼ばれます。
この記事で使うデータ
架空の顧客データ customers.csv(300人分)を使います。
library(dplyr)
cust <- read.csv("customers.csv")
head(cust)
実行結果
  customer_id frequency avg_spend
1        C001        12      3560
2        C002        13      3990
3        C003         4      2720
4        C004         4      2540
5        C005        13      4300
6 C006 5 3000| 列名 | 内容 |
|---|---|
| customer_id | 顧客ID |
| frequency | 年間の来店回数 |
| avg_spend | 1回あたりの平均購入単価(円) |
データを標準化する
k-means法は「データどうしの距離」でグループを作ります。そのため、単位や桁の違う項目をそのまま使うと、桁の大きい項目だけでグループが決まってしまいます。
今回の例では、来店回数は1〜20回程度、購入単価は数千〜1万円程度と、桁がまったく違います。そこで scale() を使って、どちらの項目も「平均0、標準偏差1」にそろえます(標準化)。
X <- scale(cust[, c("frequency", "avg_spend")])kmeans()でクラスターに分ける
3つのクラスターに分けてみます。
set.seed(1)
km <- kmeans(X, centers = 3, nstart = 25)
km$size
実行結果
[1] 126 64 110| 引数 | 意味 |
|---|---|
centers |
クラスターの数(k) |
nstart |
最初の中心の置き方を変えて何回試すか。結果が最初の置き方に左右されるので、20〜50回程度にしておくと安定する |
set.seed() は、ランダムな処理の結果を毎回同じにするためのおまじないです。
クラスターの特徴を確認する
各顧客がどのクラスターに入ったかは km$cluster に入っています。元のデータに付けて、クラスターごとの平均を見てみましょう。
cust$cluster <- factor(km$cluster)

cust %>%
  group_by(cluster) %>%
  summarise(n = n(), frequency = round(mean(frequency), 1), avg_spend = round(mean(avg_spend)))
実行結果
# A tibble: 3 × 4
  cluster     n frequency avg_spend
  <fct>   <int>     <dbl>     <dbl>
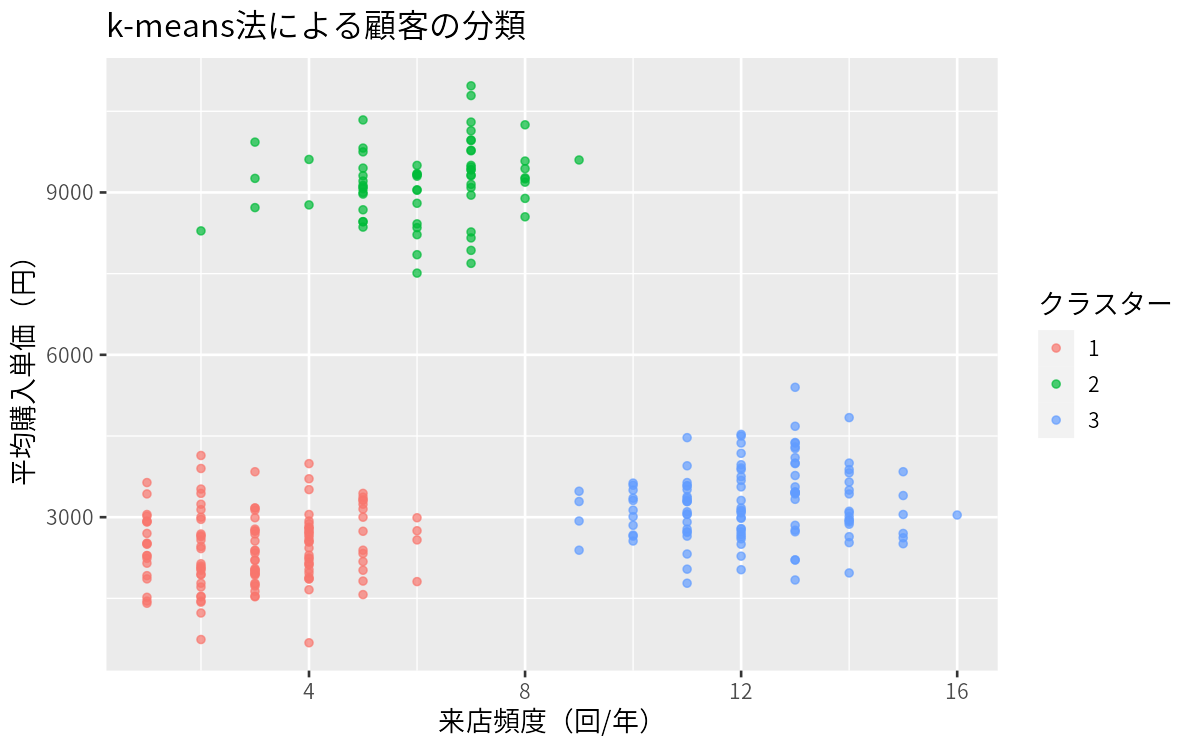
1 1         126       3        2440
2 2          64       6.1      9174
3 3         110      12.2      3257
数字から、それぞれのクラスターに名前を付けてみます。
| クラスター | 人数 | 来店回数 | 平均単価 | 名前の例 | 施策の例 |
|---|---|---|---|---|---|
| 1 | 126人 | 年3.0回 | 2,440円 | ライト層 | 来店のきっかけを作るクーポン |
| 2 | 64人 | 年6.1回 | 9,174円 | 高単価層 | 新商品・高価格帯の案内 |
| 3 | 110人 | 年12.2回 | 3,257円 | 常連層 | ポイント施策でついで買いを促す |
クラスターの番号には意味がないので、平均値を見て、ビジネスの言葉で名前を付けることが大切です。
記事の冒頭のグラフは、クラスターごとに色分けした散布図です。
library(ggplot2)
theme_set(theme_gray(base_family = "Meiryo"))  # Macは "Hiragino Sans"

ggplot(cust, aes(frequency, avg_spend, color = cluster)) +
  geom_point(alpha = 0.7) +
  labs(title = "k-means法による顧客の分類", x = "来店頻度(回/年)", y = "平均購入単価(円)", color = "クラスター")
クラスター数の決め方(エルボー法)
k-means法では、クラスターの数を自分で決める必要があります。目安を得る方法の1つがエルボー法です。クラスター数を1〜8まで変えて、「クラスター内のまとまりの悪さ(クラスター内平方和)」を計算します。
wss <- sapply(1:8, function(k) {
  set.seed(1)
  kmeans(X, centers = k, nstart = 25)$tot.withinss
})
round(wss, 1)
実行結果
[1] 598.0 319.3 51.2 41.7 32.9 28.2 24.4 20.8ggplot(data.frame(k = 1:8, wss = wss), aes(k, wss)) +
geom_line(color = "#195379") +
geom_point(size = 2.5, color = "#195379") +
scale_x_continuous(breaks = 1:8) +
labs(title = "エルボー法:クラスター数の目安", x = "クラスター数", y = "クラスター内の平方和")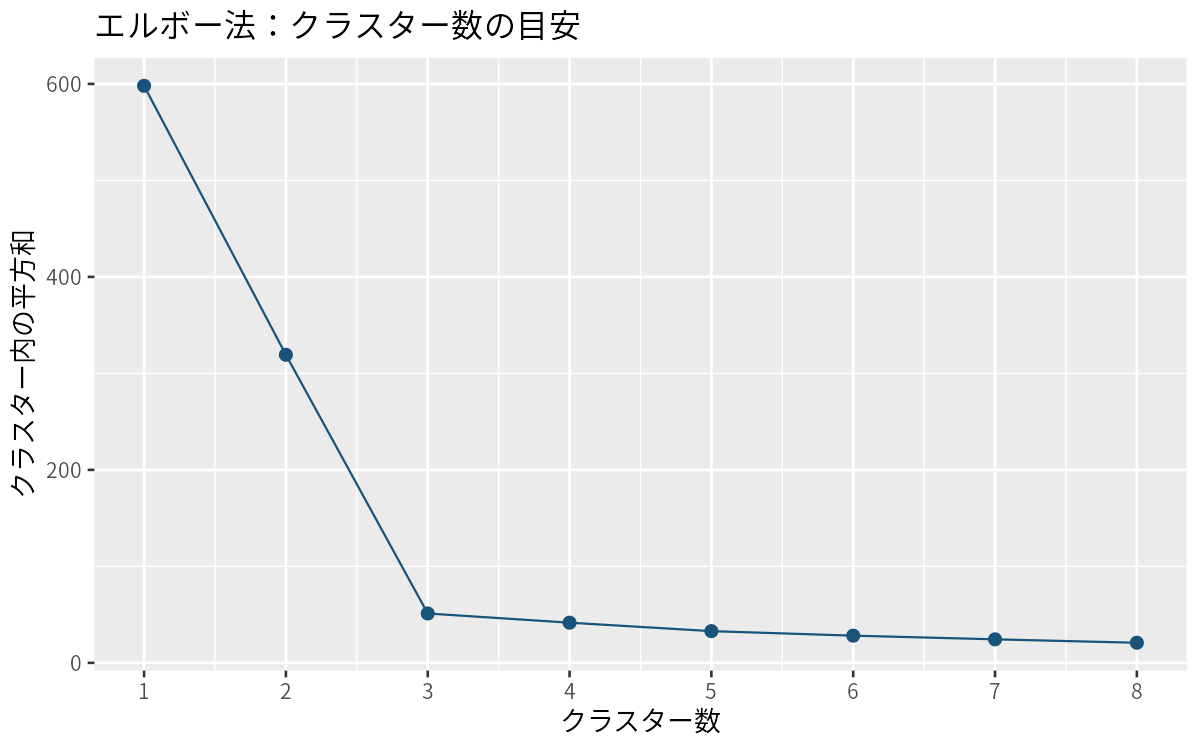
クラスター数を増やすほど値は小さくなりますが、3のところで急に下がり方がゆるやかになっています。この「ひじ(エルボー)」のように折れ曲がる点が、クラスター数の目安です。
ただし、エルボーがはっきりしないことも多いので、最終的には「施策として使い分けられる数か」「それぞれのクラスターに納得できる名前が付けられるか」で判断するのが実務的です。
k-means法を使うときの注意点
- 標準化を忘れない:桁の違う項目を使うときは、必ず
scale()で標準化します。 - 結果はランダム性に左右される:
nstartを大きめにし、set.seed()で結果を固定しましょう。 - 外れ値に弱い:極端な値を持つ顧客が少数いると、その人たちだけのクラスターができることがあります。
- 数値の項目にしか使えない:性別などのカテゴリの項目は、そのままでは使えません。
まとめ
kmeans(データ, centers = クラスター数, nstart = 25)でクラスター分析ができる- 単位の違う項目は
scale()で標準化してから使う - クラスターごとの平均を見て、ビジネスの言葉で名前を付ける
- クラスター数は、エルボー法と「施策として使えるか」で決める
顧客をいくつかのタイプに分けられると、「誰に・何を届けるか」が考えやすくなります。購買データや会員データで、ぜひ試してみてください。
同じことをGoogle ColabのPythonで行う方法は、Pythonでk-means法のクラスター分析をする方法【scikit-learnで顧客セグメンテーション入門】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。