
Pythonでk-means法のクラスター分析をする方法【scikit-learnで顧客セグメンテーション入門】
 酒井 裕麻株式会社Bistro 代表取締役社長
「よく来るけれど単価の低いお客さま」「たまにしか来ないけれど高い商品を買うお客さま」——顧客をいくつかのタイプに分けられれば、タイプごとに合った施策を考えられます。
このように、似たもの同士をグループ(クラスター)に分けるのがクラスター分析です。この記事では、代表的な方法であるk-means法を、Google ColabのPython(scikit-learn)で行う方法を解説します。
同じ分析をRで行う方法は、Rでk-means法のクラスター分析をする方法で紹介しています。
k-means法とは
k-means法は、あらかじめ決めた数(k個)のグループに、データを分ける方法です。
- k個の「中心」を、適当な場所に置く
- それぞれのデータを、いちばん近い中心のグループに入れる
- グループごとに平均の位置を計算し、そこを新しい中心にする
- 中心が動かなくなるまで、2と3を繰り返す
「近いもの同士をまとめる」というシンプルな方法なので、計算が速く、結果もわかりやすいのが特徴です。
この記事で使うデータ
架空の顧客データ customers.csv(300人分)を使います。
| 列名 | 内容 |
|---|---|
| customer_id | 顧客ID |
| frequency | 年間の来店回数 |
| avg_spend | 平均購入単価(円) |
import pandas as pd
cust = pd.read_csv("https://www.bistro.business/files/r/customers.csv")
cust.head()
実行結果
  customer_id  frequency  avg_spend
0        C001         12       3560
1        C002         13       3990
2        C003          4       2720
3        C004          4       2540
4        C005         13       4300
データを標準化する
k-means法は、データどうしの距離でグループを分けます。ところが、来店回数(1〜16回)と購入単価(数百〜1万円)では、数字の大きさがまったく違います。このままだと、数字の大きい購入単価だけで分類が決まってしまいます。
そこで、それぞれの列を平均0、標準偏差1にそろえる(標準化)ことで、2つの項目を同じ重みで扱えるようにします。scikit-learnの StandardScaler を使います。
from sklearn.preprocessing import StandardScaler

X = StandardScaler().fit_transform(cust[["frequency", "avg_spend"]])
X[:3].round(2)
実行結果
array([[ 1.14, -0.23],
       [ 1.37, -0.07],
       [-0.7 , -0.54]])
標準化した値は、「平均よりどれくらい大きいか・小さいか」を表します。たとえば、1人目の来店回数は平均より1.14標準偏差分多い、という意味です。
KMeansでクラスターに分ける
scikit-learnの KMeans で、3つのクラスターに分けます。
from sklearn.cluster import KMeans

km = KMeans(n_clusters=3, n_init=25, random_state=1)
cust["cluster"] = km.fit_predict(X)
cust["cluster"].value_counts().sort_index()
実行結果
cluster
0    126
1    110
2     64
Name: count, dtype: int64| 設定 | 意味 |
|---|---|
n_clusters=3 |
分けるクラスターの数 |
n_init=25 |
最初の中心の置き方を25通り試し、いちばんよい結果を使う |
random_state=1 |
結果を毎回同じにするための設定 |
k-means法は、最初の中心の置き方によって結果が変わることがあります。n_init で何度か試しておくと、安定した結果が得られます。
クラスターの特徴を確認する
クラスターごとの平均を見てみましょう。
cust.groupby("cluster").agg(
    n=("customer_id", "count"),
    frequency=("frequency", "mean"),
    avg_spend=("avg_spend", "mean"),
).round(1)
実行結果
           n  frequency  avg_spend
cluster
0        126        3.0     2440.1
1        110       12.2     3256.9
2         64        6.1     9173.8
数字から、それぞれのクラスターに名前を付けてみます。
| クラスター | 人数 | 来店回数 | 平均単価 | 名前の例 | 施策の例 |
|---|---|---|---|---|---|
| 0 | 126人 | 年3.0回 | 2,440円 | ライト層 | 来店のきっかけを作るクーポン |
| 1 | 110人 | 年12.2回 | 3,257円 | 常連層 | ポイント施策でついで買いを促す |
| 2 | 64人 | 年6.1回 | 9,174円 | 高単価層 | 新商品・高価格帯の案内 |
クラスターの番号には意味がないので、平均値を見て、ビジネスの言葉で名前を付けることが大切です。番号は、実行する環境やバージョンによって入れ替わることもあります。
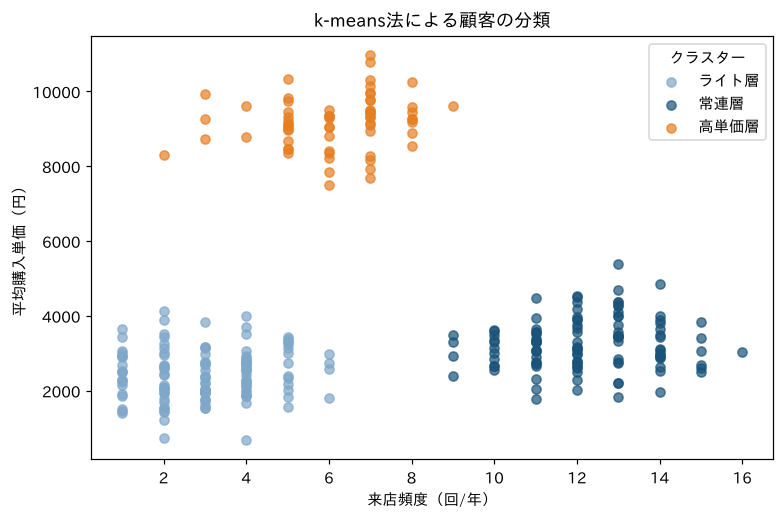
名前をデータに付けて、散布図で確認しましょう。
!pip install -q matplotlib-fontjaimport matplotlib.pyplot as plt
import matplotlib_fontja
names = {0: "ライト層", 1: "常連層", 2: "高単価層"}
colors = {"ライト層": "#7FA7C9", "常連層": "#195379", "高単価層": "#E67E22"}
cust["segment"] = cust["cluster"].map(names)
fig, ax = plt.subplots(figsize=(8, 5))
for seg, d in cust.groupby("segment"):
ax.scatter(d["frequency"], d["avg_spend"], alpha=0.7, color=colors[seg], label=seg)
ax.set_title("k-means法による顧客の分類")
ax.set_xlabel("来店頻度(回/年)")
ax.set_ylabel("平均購入単価(円)")
ax.legend(title="クラスター")
plt.show()
3つのグループに、きれいに分かれていることがわかります。
クラスター数の決め方
k-means法では、クラスターの数を自分で決める必要があります。目安を知る方法を2つ紹介します。
エルボー法
クラスターの数を1から8まで変えて、それぞれクラスター内のまとまりの悪さ(クラスター内の平方和)を計算します。scikit-learnでは inertia_ で取得できます。
inertia = [KMeans(n_clusters=k, n_init=25, random_state=1).fit(X).inertia_ for k in range(1, 9)]
[round(v, 1) for v in inertia]
実行結果
[600.0, 320.3, 51.4, 41.8, 33.0, 28.3, 24.5, 21.1]fig, ax = plt.subplots(figsize=(7, 4.5))
ax.plot(range(1, 9), inertia, marker="o", color="#195379")
ax.set_title("エルボー法:クラスター数の目安")
ax.set_xlabel("クラスター数")
ax.set_ylabel("クラスター内の平方和")
plt.show()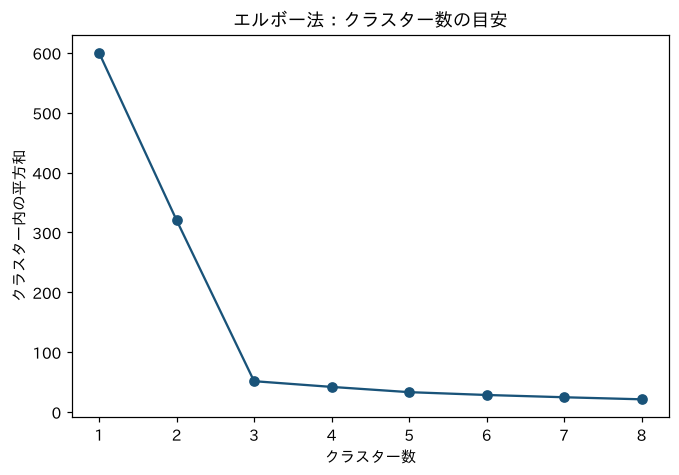
クラスターを増やすほど値は小さくなりますが、3を過ぎると、ほとんど下がらなくなります。グラフがひじ(エルボー)のように折れ曲がる点が、クラスター数の目安です。今回は3がちょうどよいことがわかります。
シルエット係数
もう一つの目安が、シルエット係数です。「同じクラスターの中ではまとまっていて、ほかのクラスターとは離れているか」を、-1〜1の値で表します。1に近いほど、きれいに分かれています。
from sklearn.metrics import silhouette_score

for k in range(2, 7):
    labels = KMeans(n_clusters=k, n_init=25, random_state=1).fit_predict(X)
    print(k, round(silhouette_score(X, labels), 3))
実行結果
2 0.553
3 0.759
4 0.624
5 0.483
6 0.402
クラスター数が3のときに、シルエット係数が最も高くなりました。エルボー法と同じ結論です。
ただし、実際のデータでは、ここまではっきり決まらないこともよくあります。最終的には、施策に使いやすい数か(担当者が扱える数か、それぞれに違う施策を考えられるか)も考えて決めましょう。
k-means法を使うときの注意点
- 標準化を忘れない:数字の大きさが違う項目を使うときは、必ず標準化します
- 外れ値に弱い:極端な値の顧客がいると、中心が引っ張られます。事前に外れ値を確認しておきましょう(Pythonでヒストグラムと箱ひげ図を作る方法)
- 丸い形のグループを前提にしている:細長い形や、入り組んだ形のグループは、うまく分けられないことがあります
- 使う項目で結果が決まる:どの項目でグループを分けるかが、最も大切な判断です。施策につながる項目を選びましょう
まとめ
- k-means法は、近いもの同士を、決めた数のグループに分ける方法
- 単位の違う項目を使うときは、
StandardScalerで標準化する - scikit-learnの
KMeans(n_clusters=k, n_init=25)で分類する - クラスターの番号には意味がないので、平均を見て名前を付ける
- クラスター数は、エルボー法・シルエット係数と、施策での使いやすさで決める
項目が多いときは、主成分分析で項目を要約してから、クラスター分析をすることもあります。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。