
Pythonでヒストグラムと箱ひげ図を作る方法【matplotlib・seabornでデータの分布と外れ値を見る】
 酒井 裕麻株式会社Bistro 代表取締役社長
平均だけを見ていると、データの大事な特徴を見落とすことがあります。たとえば、平均点が同じでも、「みんなが平均点の近くにいる」のか、「高い人と低い人に分かれている」のかで、取るべき対策は変わります。
データの分布(値がどのように散らばっているか)を見るのに使うのが、ヒストグラムと箱ひげ図です。この記事では、Google ColabのPythonで、この2つのグラフを作る方法と読み方を解説します。
同じグラフをRで作る方法は、Rでヒストグラムと箱ひげ図を作る方法で紹介しています。
この記事で使うデータ
- 架空の商品アンケート survey.csv(400人分。総合満足度は0〜10点)
- 架空の店舗の売上データ sales.csv(2026年1〜3月の日別データ)
!pip install -q matplotlib-fontjaimport pandas as pd
import matplotlib.pyplot as plt
import matplotlib_fontja
import seaborn as sns
survey = pd.read_csv("https://www.bistro.business/files/r/survey.csv")
sales = pd.read_csv("https://www.bistro.business/files/r/sales.csv")ヒストグラム:値がどのあたりに集まっているか
ヒストグラムは、値をいくつかの区間に分けて、それぞれの区間に入るデータの数を棒の高さで表したグラフです。満足度の分布を見てみましょう。
fig, ax = plt.subplots(figsize=(8, 4.5))
ax.hist(survey["satisfaction"], bins=range(0, 12), color="#195379", edgecolor="white", align="left")
ax.set_xticks(range(0, 11))
ax.set_title("満足度の分布(ヒストグラム)")
ax.set_xlabel("満足度(0〜10)")
ax.set_ylabel("人数")
plt.show()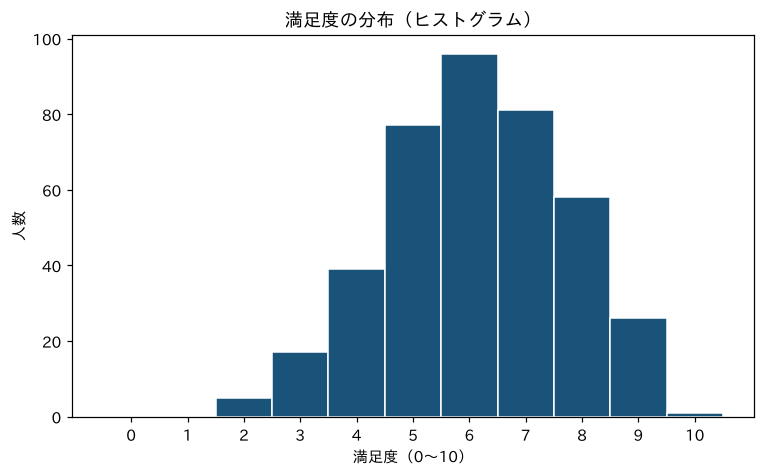
bins で、区間の区切りを指定します。満足度は0〜10の整数なので、range(0, 12) で1点刻みにし、align="left" で棒を目盛りの真上に合わせています。
満足度は6点を中心に、山が1つの形に分布しています。極端に低い人や高い人は少ないことがわかります。
| 分布の形 | 読み取れること |
|---|---|
| 山が1つで左右対称 | 平均で全体を代表させてよい |
| 右(大きい値の側)に長く裾を引く | 一部の大きな値に平均が引っ張られる。中央値も見る |
| 山が2つある | 性質の違う2つのグループが混ざっている可能性 |
手早く確認するなら pandas の hist()
pandasの hist() を使うと、1行でヒストグラムを描けます。数値の列をまとめて確認したいときにも便利です。
survey[["awareness", "price_sat", "satisfaction"]].hist(bins=10, figsize=(10, 3), layout=(1, 3), color="#195379")
plt.tight_layout()
plt.show()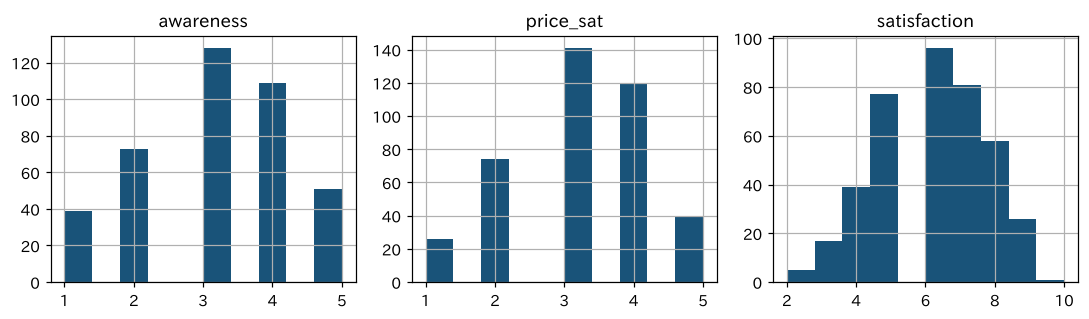
箱ひげ図:グループごとのばらつきを比べる
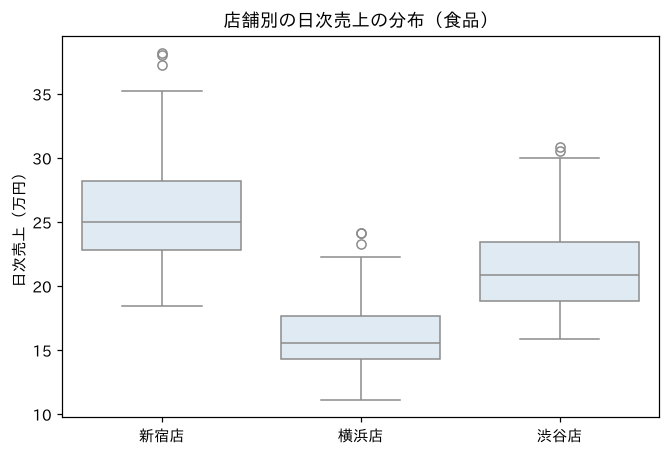
箱ひげ図は、グループごとの分布を並べて比べるのに向いています。食品カテゴリの、店舗別の日次売上を比べてみましょう。seabornの boxplot() を使います。
food = sales.query("category == '食品'").assign(sales_man=lambda d: d["sales"] / 10000)

fig, ax = plt.subplots(figsize=(7, 4.5))
sns.boxplot(data=food, x="store", y="sales_man", color="#DCEBF5", ax=ax)
ax.set_title("店舗別の日次売上の分布(食品)")
ax.set_xlabel("")
ax.set_ylabel("日次売上(万円)")
plt.show()
箱ひげ図の読み方
| 部分 | 意味 |
|---|---|
| 箱の中の線 | 中央値(真ん中の値) |
| 箱の下の端・上の端 | 下から25%・75%の位置の値(データの真ん中の半分が箱に入る) |
| ひげ | 箱の長さの1.5倍までの範囲にある、最小値・最大値 |
| 点 | ひげの外にある外れ値 |
新宿店は中央値が高く、箱も長い(日によるばらつきが大きい)ことがわかります。横浜店は、売上の水準が低く、ばらつきも小さめです。
箱ひげ図の数値を確認する
箱ひげ図の数値は、describe() や quantile() で確認できます。
food.groupby("store")["sales_man"].describe().round(1)実行結果
       count  mean  std   min   25%   50%   75%   max
store
新宿店     90.0  26.0  4.5  18.5  22.8  25.0  28.2  38.2
横浜店     90.0  16.3  3.1  11.1  14.3  15.5  17.6  24.1
渋谷店 90.0 21.5 3.8 15.9 18.8 20.9 23.4 30.925%・50%・75% が、箱の下の端・中央値・箱の上の端にあたります。
外れ値を数値で探す
ひげの外にある外れ値は、次のように計算して探せます。「箱の長さ(IQR)」の1.5倍を、箱の上下に足した範囲の外にあるデータが外れ値です。
def find_outliers(s):
    q1, q3 = s.quantile([0.25, 0.75])
    iqr = q3 - q1
    return (s < q1 - 1.5 * iqr) | (s > q3 + 1.5 * iqr)

food[food.groupby("store")["sales_man"].transform(find_outliers)][["date", "store", "sales_man"]]
実行結果
           date store  sales_man
82   2026-01-10   新宿店     38.032
160  2026-01-18   渋谷店     30.876
271  2026-01-31   新宿店     38.161
274  2026-01-31   横浜店     23.260
277  2026-01-31   渋谷店     30.539
337  2026-02-07   横浜店     24.088
652  2026-03-14   横浜店     24.109
775  2026-03-28   新宿店     37.231
8日分が外れ値として見つかりました。1月31日は3店舗とも外れ値になっているので、全店でセールなど特別なことがあった日かもしれません。このように、外れ値が出ている日は、特別な理由がなかったかを確認してみると、新しい発見につながることがあります。
ヒストグラムを重ねて比べる
グループごとのヒストグラムを、半透明にして重ねることもできます。seabornの histplot() で、hue にグループの列を指定します。
fig, ax = plt.subplots(figsize=(8, 4.5))
sns.histplot(data=food, x="sales_man", hue="store", binwidth=2, alpha=0.5, element="bars", ax=ax)
ax.set_title("店舗別の日次売上の分布を重ねる")
ax.set_xlabel("日次売上(万円)")
ax.set_ylabel("日数")
plt.show()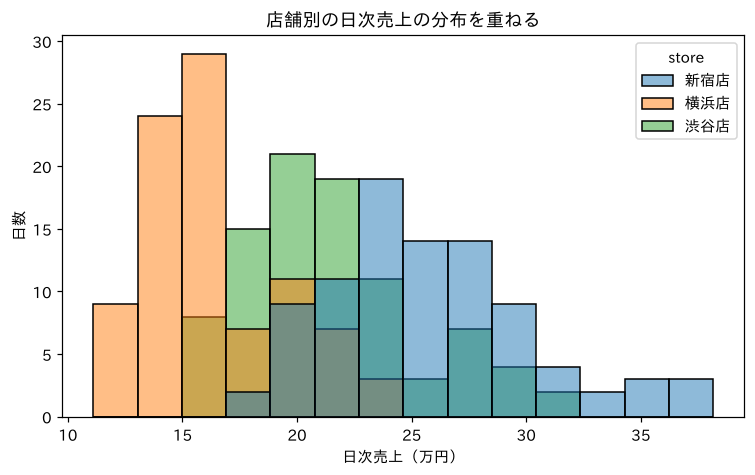
横浜店は低い側、新宿店は高い側に分布していて、重なりながらも店舗ごとに水準が違うことがわかります。グループが多いと重なって見にくくなるので、そのときは箱ひげ図を使いましょう。
どちらを使えばいい?
| グラフ | 向いている場面 |
|---|---|
| ヒストグラム | 1つのグループの分布の形(山の数、偏り)を詳しく見たい |
| 箱ひげ図 | 複数のグループの中央値やばらつき、外れ値を一度に比べたい |
まとめ
- ヒストグラムは
ax.hist()やdf.hist()。分布の形がわかる - 箱ひげ図は seaborn の
sns.boxplot()。中央値・ばらつき・外れ値をグループごとに比べられる - 箱ひげ図の数値は
describe()で確認できる - 外れ値は、箱の長さの1.5倍を基準に探せる
分析の最初に分布を見ておくと、「平均で比べてよいデータか」「外れ値を除くべきか」といった判断がしやすくなります。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。