
Pythonでアンケートの自由回答をテキストマイニングする方法【janomeで頻出語・満足度別の比較】
 酒井 裕麻株式会社Bistro 代表取締役社長
アンケートの自由回答は、お客さまの本音が詰まった宝の山です。ところが、数百件、数千件になると、すべてを読んで整理するのは大変です。
そこで役立つのがテキストマイニングです。この記事では、Google ColabのPythonで、自由回答を単語に分け、よく出てくる言葉や、満足度の高い人と低い人で使われる言葉の違いを調べる方法を解説します。
同じ分析をRで行う方法は、Rでアンケートの自由回答をテキストマイニングする方法で紹介しています。
日本語のテキストマイニングには「形態素解析」が必要
英語は単語の間にスペースがあるので、スペースで区切れば単語に分けられます。一方、日本語は単語がつながっているので、まず文章を単語に分ける作業が必要です。これを形態素解析と呼びます。
Pythonで日本語の形態素解析をするライブラリには、いくつかの種類があります。
| ライブラリ | 特徴 |
|---|---|
| janome | Pythonだけで動くので、pip install だけですぐ使える。この記事で使う |
| fugashi(MeCab) | 高速。大量の文章を扱うときに向いている。辞書のインストールも必要 |
| SudachiPy | 新しい辞書で、新語や表記ゆれに強い |
ここでは、Colabでのインストールが最も簡単な janome を使います。
!pip install -q janome matplotlib-fontja試しに、短い文章を単語に分けてみましょう。
from janome.tokenizer import Tokenizer

t = Tokenizer()
for token in t.tokenize("今日はとても良い天気です"):
    print(token.surface, token.part_of_speech.split(",")[0], token.base_form, sep="\t")
実行結果
今日	名詞	今日
は	助詞	は
とても	副詞	とても
良い	形容詞	良い
天気	名詞	天気
です 助動詞 です左から、文章中の形、品詞、基本形(辞書に載っている形)です。「良い」のような言葉は、文章によって「良く」「良かっ」と形が変わるので、集計には基本形を使います。
この記事で使うデータ
飲食店の架空のアンケート free_answers.csv(300件)を使います。満足度(1〜10)と、自由回答のコメントが入っています。
import pandas as pd

fa = pd.read_csv("https://www.bistro.business/files/r/free_answers.csv")
fa.head(3)
実行結果
   id  satisfaction                               comment
0   1             6     デザートがおいしくてまた来たいです。量の割に値段が高いと思います。
1   2             7  季節のメニューが楽しみです。料理が出てくるまでの待ち時間が長かったです。
2   3             9      店員さんの笑顔が素敵でした。予約の電話がつながりにくかったです。
手順1:すべての回答を単語に分ける
300件のコメントを、すべて単語に分けて、1行に1単語の表にします。どの回答の単語かがわかるように、回答の id も残しておきます。
rows = []
for id_, comment in zip(fa["id"], fa["comment"]):
    for token in t.tokenize(comment):
        rows.append({
            "id": id_,
            "word": token.base_form,
            "pos": token.part_of_speech.split(",")[0],
        })
tok = pd.DataFrame(rows)
tok.head(8)
実行結果
   id  word  pos
0   1  デザート   名詞
1   1     が   助詞
2   1  おいしい  形容詞
3   1     て   助詞
4   1    また   副詞
5   1    来る   動詞
6   1    たい  助動詞
7   1    です  助動詞
手順2:意味のある言葉だけを残す
「は」「が」のような助詞や、「です」のような助動詞は、どの回答にも出てくるので、分析には役立ちません。名詞・形容詞・動詞だけを残します。
さらに、「する」「ある」「こと」のように、意味の薄い言葉(ストップワード)も除きます。
stop = ["する", "ある", "いる", "なる", "来る", "くる", "思う", "にくい",
        "の", "さん", "こと", "もう少し", "少し", "ちょうど", "とても"]

words = tok[tok["pos"].isin(["名詞", "形容詞", "動詞"]) & ~tok["word"].isin(stop)]
len(words)
実行結果
1551ストップワードは、最初から完璧に決める必要はありません。集計してみて、意味のない言葉が上位に出てきたら追加する、という手順で調整していきます。
手順3:よく出てくる言葉を数える
いくつの回答に出てきたかを数えます。1つの回答で同じ言葉を何度も使っていても1回と数えるように、drop_duplicates() で、回答と単語の組み合わせの重複を除いてから数えます。
freq = (
    words.drop_duplicates(["id", "word"])
    .groupby(["word", "pos"]).size()
    .sort_values(ascending=False)
    .reset_index(name="n")
)
freq.head(15)
実行結果
    word  pos   n
0     料理   名詞  93
1   おいしい  形容詞  60
2    雰囲気   名詞  54
3     店員   名詞  51
4      量   名詞  48
5     値段   名詞  44
6     高い  形容詞  44
7    ランチ   名詞  42
8     長い  形容詞  37
9   待ち時間   名詞  37
10    季節   名詞  31
11  メニュー   名詞  31
12    笑顔   名詞  31
13    素敵   名詞  31
14   楽しみ   名詞  31
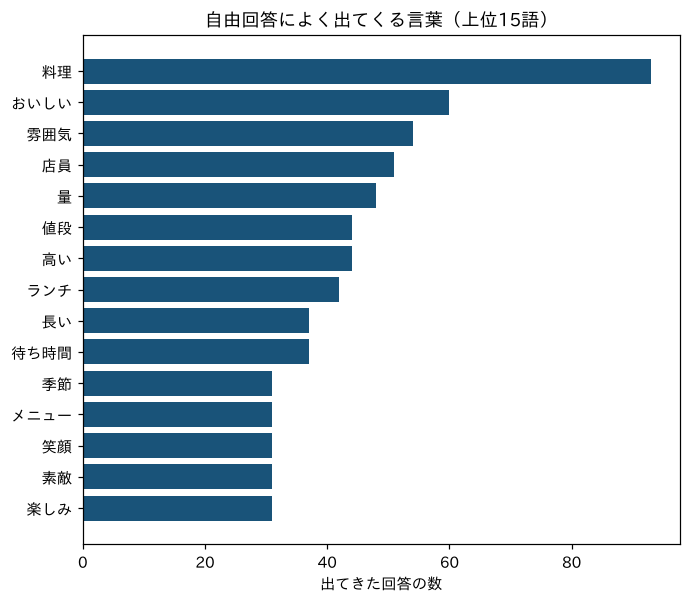
棒グラフにしてみましょう。
import matplotlib.pyplot as plt
import matplotlib_fontja

top = freq.head(15).iloc[::-1]  # 横棒グラフで上から多い順にするため、逆順にする
fig, ax = plt.subplots(figsize=(7, 6))
ax.barh(top["word"], top["n"], color="#195379")
ax.set_title("自由回答によく出てくる言葉(上位15語)")
ax.set_xlabel("出てきた回答の数")
plt.show()
「料理」「おいしい」「雰囲気」「店員」など、料理の味やお店の雰囲気、接客に関する言葉が多く出てきています。「高い」「長い」「待ち時間」のような、不満につながりそうな言葉も上位に入っています。
手順4:満足度の高い人と低い人で比べる
よく出てくる言葉がわかったら、次は満足度の高い人と低い人で、使っている言葉がどう違うかを比べます。
満足度8以上を「高い(high)」、5以下を「低い(low)」のグループに分けます。
fa["group"] = pd.cut(fa["satisfaction"], bins=[0, 5, 7, 10], labels=["low", "middle", "high"])
fa["group"].value_counts()
実行結果
group
high      122
middle    114
low        64
Name: count, dtype: int64グループごとに、それぞれの言葉が何%の回答に出てきたかを計算し、その差を出します。グループの人数が違うので、件数ではなく割合で比べるのがポイントです。
n_group = fa["group"].value_counts()

cmp = (
    words.drop_duplicates(["id", "word"])
    .merge(fa[["id", "group"]], on="id")
    .query("group != 'middle'")
    .groupby(["word", "group"], observed=True).size()
    .unstack(fill_value=0)
)
cmp = cmp.div(n_group[cmp.columns]) * 100   # 回答者数で割って%にする
cmp["diff"] = cmp["high"] - cmp["low"]
cmp = cmp.sort_values("diff", ascending=False).round(1)
cmp.head(8)
実行結果
group  low  high  diff
word
おいしい   4.7  30.3  25.6
雰囲気    4.7  26.2  21.5
素敵     1.6  17.2  15.7
笑顔     1.6  17.2  15.7
よい     3.1  16.4  13.3
デザート   1.6  14.8  13.2
セット    0.0  13.1  13.1
得      0.0  13.1  13.1
満足度の高い人のほうが多く使っている言葉です。
cmp.tail(8)実行結果
group   low  high  diff
word
昼      15.6   2.5 -13.2
時間     15.6   2.5 -13.2
出る     14.1   0.8 -13.2
つながる   20.3   2.5 -17.9
予約     20.3   2.5 -17.9
電話     20.3   2.5 -17.9
待ち時間   28.1   3.3 -24.8
長い     28.1   3.3 -24.8
こちらは、満足度の低い人のほうが多く使っている言葉です。
| 満足度が高い人に多い言葉 | 満足度が低い人に多い言葉 |
|---|---|
| おいしい、雰囲気、素敵、笑顔、デザート など | 待ち時間、長い、予約、電話、つながる など |
満足度の高い人は「料理がおいしい」「雰囲気が素敵」「店員さんの笑顔」といった体験を、満足度の低い人は「待ち時間が長い」「予約の電話がつながらない」といった不満を書いていることがわかります。満足度を上げるには、待ち時間と予約の電話への対策が重要そうです。全体でよく出てきた「高い」「値段」は、満足度が中くらい(6〜7)の人に多く、満足度の高い人と低い人の差は、「待ち時間」ほど大きくはありませんでした。
手順5:元の文章を読んで確かめる
テキストマイニングで気になる言葉が見つかったら、必ず元の文章を読んで確かめましょう。言葉だけでは、良い意味なのか悪い意味なのかがわからないことがあるためです。
for c in fa.loc[fa["comment"].str.contains("待ち時間"), "comment"].head(3):
    print(c)
実行結果
季節のメニューが楽しみです。料理が出てくるまでの待ち時間が長かったです。
料理がとてもおいしかったです。昼の時間は待ち時間が長くて困りました。
料理が出てくるまでの待ち時間が長かったです。
「待ち時間」は、いずれも「長かった」という不満として書かれていることが確認できます。
テキストマイニングの注意点
- 言葉の数え方で結果が変わる:基本形にするか、ストップワードに何を入れるかで、結果は変わります。何度か試して調整しましょう
- 言葉の意味までは分からない:「高い」は「価格が高い(不満)」にも「質が高い(満足)」にもなります。必ず元の文章で確認します
- 否定に注意:「おいしくない」は、「おいしい」と「ない」に分かれます。否定の表現が多い場合は、2つの言葉の組み合わせ(「おいしい+ない」)で数える工夫が必要です
- 新語や固有名詞:商品名や新しい言葉は、うまく分けられないことがあります。janomeでは、ユーザー辞書を追加して対応できます
まとめ
- 日本語のテキストマイニングには、形態素解析で単語に分ける作業が必要
- Colabでは、
!pip install janomeで、すぐに形態素解析ができる - 名詞・形容詞・動詞の基本形を残し、ストップワードを除いて集計する
- グループごとに「何%の回答に出てきたか」を比べると、違いが見える
- 気になる言葉は、必ず元の文章を読んで確かめる
株式会社Bistroでは、アンケートの設計から、自由回答のテキストマイニング、分析レポートの作成までご支援しています。お気軽にご相談ください。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。