
Pythonで主成分分析(PCA)をする方法【scikit-learnの使い方と結果の読み方】
 酒井 裕麻株式会社Bistro 代表取締役社長
アンケートで「味」「香り」「見た目」「価格」「量」「入手しやすさ」など、たくさんの項目を聞いたものの、項目が多すぎて全体像がつかめない——そんなときに役立つのが主成分分析(PCA)です。
主成分分析を使うと、たくさんの項目を、少ない数の「軸」に要約できます。この記事では、Google ColabのPython(scikit-learn)で主成分分析を行い、結果を読み取る方法を解説します。
同じ分析をRで行う方法は、Rで主成分分析(PCA)をする方法で紹介しています。
主成分分析とは
主成分分析は、似た動きをする項目をまとめて、新しい軸を作る分析です。
たとえば、「味」の評価が高い人は「香り」や「見た目」の評価も高い傾向があるなら、この3つは「おいしさ・品質」という1つの軸にまとめられそうです。主成分分析は、このようなまとめ方を、データから自動で見つけてくれます。
まとめてできた新しい軸を主成分と呼び、データのばらつきを最も多く説明する軸から順に、第1主成分、第2主成分…となります。
この記事で使うデータ
架空の商品評価アンケート product_eval.csv(200人分、各項目1〜5点程度)を使います。
import pandas as pd
ev = pd.read_csv("https://www.bistro.business/files/r/product_eval.csv")
ev.head(3)
実行結果
     味   香り  見た目   価格    量  入手しやすさ
0  4.9  4.1  4.5  5.4  4.7     4.7
1  2.5  2.1  1.9  3.4  3.7     3.9
2  2.1  2.2  1.6  3.1  2.7     3.9
データを標準化する
主成分分析では、まず各項目を平均0、標準偏差1にそろえる(標準化)のが基本です。項目によって点数の幅が違うと、幅の大きい項目だけが強く影響してしまうためです。
from sklearn.preprocessing import StandardScaler
X = StandardScaler().fit_transform(ev)
PCAで主成分分析をする
scikit-learnの PCA で主成分分析を行います。
from sklearn.decomposition import PCA

pca = PCA()
scores = pca.fit_transform(X)

summary = pd.DataFrame({
    "寄与率": pca.explained_variance_ratio_,
    "累積寄与率": pca.explained_variance_ratio_.cumsum(),
    "固有値": pca.explained_variance_,
}, index=[f"PC{i}" for i in range(1, 7)]).round(3)
summary
実行結果
       寄与率  累積寄与率    固有値
PC1  0.381  0.381  2.298
PC2  0.355  0.736  2.138
PC3  0.100  0.835  0.601
PC4  0.075  0.911  0.455
PC5  0.047  0.958  0.283
PC6 0.042 1.000 0.256| 項目 | 意味 |
|---|---|
| 寄与率 | その主成分が、データ全体の情報(ばらつき)の何%を説明しているか |
| 累積寄与率 | 第1主成分からその主成分までで、合計何%を説明しているか |
| 固有値 | その主成分が、元の項目何個分の情報を持っているか |
第1主成分(PC1)が38.1%、第2主成分(PC2)が35.5%で、この2つだけで6項目の情報の73.6%を説明できています。6つの項目を、2つの軸に要約できたことになります。
主成分はいくつ使えばいい?
使う主成分の数は、次のような目安で決めます。
- 累積寄与率が70〜80%を超えるところまで
- 固有値が1以上の主成分(元の項目1個分より多くの情報を持っている主成分)
今回は、どちらの目安でも2つです。PC3以降は寄与率が10%以下と小さく、PC2との間で大きく下がっています。
主成分負荷量で、軸の意味を読み取る
それぞれの主成分が何を表しているかは、components_ で、元の項目とどれくらい関係しているかを見て読み取ります。
loadings = pd.DataFrame(pca.components_[:2].T, index=ev.columns, columns=["PC1", "PC2"])
loadings.round(3)
実行結果
          PC1    PC2
味       0.585 -0.006
香り      0.591 -0.013
見た目     0.545 -0.046
価格      0.095  0.597
量       0.004  0.615
入手しやすさ -0.044 0.513| 主成分 | 値が大きい項目 | 軸の意味 |
|---|---|---|
| PC1 | 味・香り・見た目 | 「おいしさ・品質」の軸 |
| PC2 | 価格・量・入手しやすさ | 「お得さ・手軽さ」の軸 |
数字の絶対値が大きい項目ほど、その主成分と強く関係しています。今回はどちらもプラスの値が大きいので、「PC1が大きいほど品質の評価が高い」「PC2が大きいほどお得さの評価が高い」という向きになります。
なお、主成分の向き(プラス・マイナス)は、計算の都合で反転することがあります。Rの prcomp() では、同じデータでもマイナスの向きで出ることがありますが、意味は同じです。
※厳密には、components_ は「固有ベクトル」と呼ばれる値です。元の項目と主成分の相関(主成分負荷量)にしたいときは、components_.T * np.sqrt(pca.explained_variance_) で計算できます。
主成分得点
一人ひとりの回答者が、それぞれの主成分でどんな値になるかを、主成分得点と呼びます。fit_transform() の結果に入っています。
pd.DataFrame(scores[:, :2], columns=["PC1", "PC2"]).head(3).round(2)実行結果
    PC1   PC2
0  2.69  3.23
1 -1.64  1.26
2 -2.03 0.481人目はPC1・PC2ともに大きなプラスで、品質もお得さも高く評価している人だとわかります。この得点を使って、k-means法などで回答者をグループ分けすることもできます。
バイプロットで見える化する
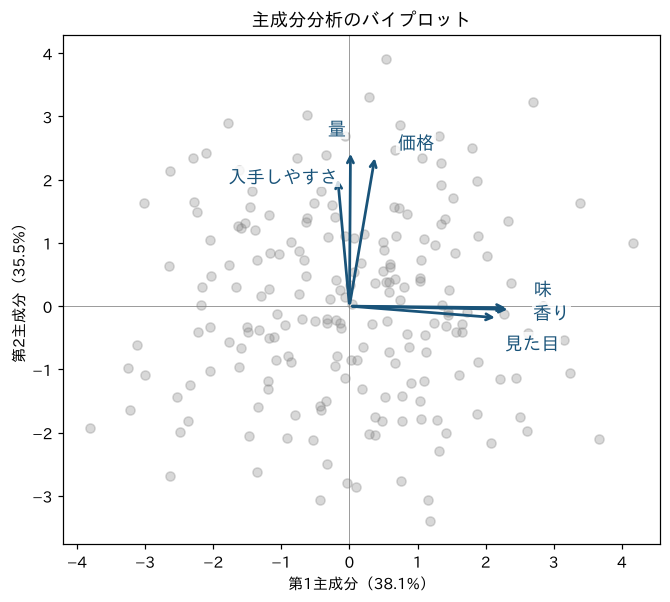
主成分得点(回答者)と、元の項目の向きを、1つの図に重ねたものをバイプロットと呼びます。
!pip install -q matplotlib-fontjaimport matplotlib.pyplot as plt
import matplotlib_fontja
ratio = pca.explained_variance_ratio_ * 100
# ラベルが重ならないように、少しずらす位置
offset = {"味": (0.5, 0.3), "香り": (0.6, -0.05), "見た目": (0.5, -0.4),
"価格": (0.6, 0.2), "量": (-0.2, 0.35), "入手しやすさ": (-0.8, 0.0)}
fig, ax = plt.subplots(figsize=(7, 6))
ax.scatter(scores[:, 0], scores[:, 1], alpha=0.3, color="grey")
for name, (x, y) in loadings.iterrows():
ax.annotate("", xy=(x * 4, y * 4), xytext=(0, 0),
arrowprops=dict(arrowstyle="->", color="#195379", linewidth=1.8))
dx, dy = offset[name]
ax.text(x * 4 + dx, y * 4 + dy, name, color="#195379", fontsize=12, ha="center", va="center",
bbox=dict(facecolor="white", edgecolor="none", alpha=0.8, pad=1))
ax.axhline(0, color="grey", linewidth=0.5)
ax.axvline(0, color="grey", linewidth=0.5)
ax.set_title("主成分分析のバイプロット")
ax.set_xlabel(f"第1主成分({ratio[0]:.1f}%)")
ax.set_ylabel(f"第2主成分({ratio[1]:.1f}%)")
plt.show()
矢印は、それぞれの項目がどの方向に効いているかを表します(見やすいように4倍に伸ばしています)。「味・香り・見た目」の矢印は右(PC1の方向)へ、「価格・量・入手しやすさ」の矢印は上(PC2の方向)へ伸びていて、6つの項目がきれいに2つのグループに分かれていることがわかります。
右上にいる回答者ほど、品質もお得さも高く評価している、という見方ができます。
主成分分析を使う場面
| 場面 | 使い方 |
|---|---|
| アンケートの項目が多い | 項目を少数の軸に要約し、全体像をつかむ |
| ブランドや商品の比較 | 主成分得点でポジショニングマップを作る |
| 顧客のグループ分け | 主成分得点を使って、クラスター分析をする |
| 回帰分析の前処理 | 互いに相関の強い項目をまとめて、多重共線性を避ける |
まとめ
- 主成分分析は、たくさんの項目を少ない数の軸に要約する方法
StandardScalerで標準化してから、scikit-learnのPCAで分析する- 寄与率・累積寄与率(
explained_variance_ratio_)で、使う主成分の数を決める components_で、それぞれの主成分の意味を読み取る- 主成分得点(
fit_transform()の結果)を使って、回答者の位置を比べたり、グループ分けしたりできる
アンケートの「ブランド×イメージ」のような集計表を地図にしたいときは、コレスポンデンス分析が向いています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。