
Rでコレスポンデンス分析をする方法【ブランドイメージのポジショニングマップ】
 酒井 裕麻株式会社Bistro 代表取締役社長
「ブランドAは高級感、ブランドBは親しみやすさ」──アンケートで集めたブランドイメージのクロス集計表を、1枚の地図(ポジショニングマップ)にして、どのブランドがどんなイメージを持たれているかをひと目でわかるようにする方法がコレスポンデンス分析です。
市場調査の現場でとてもよく使われる手法で、競合との位置関係を説明する資料にもそのまま使えます。この記事では、Rの ca パッケージを使ったコレスポンデンス分析のやり方を解説します。
参考記事
Rで基本統計量とクロス集計を出す方法【summary・table・prop.table】
Rで主成分分析(PCA)をする方法【prcompの使い方と結果の読み方】
コレスポンデンス分析とは
コレスポンデンス分析は、クロス集計表の行と列の関係を、2次元の地図に表す方法です。
- よく一緒に選ばれるブランドとイメージは、地図上で近くに配置される
- 似たイメージを持たれているブランドどうしも、近くに配置される
数値の項目をまとめる主成分分析に対して、コレスポンデンス分析は「人数(度数)のクロス集計表」をまとめる方法、と考えるとわかりやすいでしょう。
この記事で使うデータ
架空のブランドイメージ調査の結果 brand_image.csv を使います。5つのブランドそれぞれについて、各イメージに「当てはまる」と答えた人数をまとめたクロス集計表です。
install.packages("ca")  # 最初の1回だけ
library(ca)

bi <- read.csv("brand_image.csv", check.names = FALSE)
tab <- as.matrix(bi[, -1])     # 1列目(ブランド名)以外を行列にする
rownames(tab) <- bi$brand      # 行の名前にブランド名を付ける
tab
実行結果
          高級感 親しみやすい おしゃれ 安い 信頼できる 革新的
ブランドA     62           15       40    5         48     22
ブランドB     12           58       20   45         25      8
ブランドC     30           22       55   10         18     50
ブランドD      8           40       12   60         30      6
ブランドE     45           18       25    8         60     35
数字の表を眺めるだけでも傾向はつかめますが、ブランドやイメージの数が増えると、全体の関係を把握するのは難しくなります。
ca()で分析する
res <- ca(tab)寄与率:地図がどれくらい情報を表しているか
round(res$sv^2 / sum(res$sv^2) * 100, 1)実行結果
[1] 76.1 17.2 4.1 2.5第1軸が76.1%、第2軸が17.2%で、2つの軸を合わせて93.3%の情報を表せています。2次元の地図で、元のクロス集計表の関係をほぼ再現できているといえます。
※累積の寄与率が低い(たとえば60%以下)場合は、2次元の地図だけでは表しきれない関係がある、ということに注意して読み取りましょう。
座標を確認する
ブランド(行)とイメージ(列)それぞれの、地図上の位置を確認します。
round(res$rowcoord[, 1:2], 3)
round(res$colcoord[, 1:2], 3)
実行結果
            Dim1   Dim2
ブランドA  0.860 -0.862
ブランドB -1.171  0.229
ブランドC  0.710  1.789
ブランドD -1.472 -0.271
ブランドE  0.680 -0.846

               Dim1   Dim2
高級感        0.942 -0.929
親しみやすい -1.047  0.348
おしゃれ      0.605  1.135
安い         -1.806  0.025
信頼できる    0.220 -1.348
革新的        0.923  1.328
ポジショニングマップを作る
plot(res) だけでも地図は描けますが、日本語のラベルが重なって読みにくくなりがちです。ここでは、ggplot2とggrepelで見やすいマップを作ります。
library(ggplot2)
library(ggrepel)
theme_set(theme_gray(base_family = "Meiryo"))  # Macは "Hiragino Sans"

row_df <- data.frame(name = rownames(tab),
                     x = res$rowcoord[, 1] * res$sv[1], y = res$rowcoord[, 2] * res$sv[2],
                     type = "ブランド")
col_df <- data.frame(name = colnames(tab),
                     x = res$colcoord[, 1] * res$sv[1], y = res$colcoord[, 2] * res$sv[2],
                     type = "イメージ")
plot_df <- rbind(row_df, col_df)
inertia <- round(res$sv^2 / sum(res$sv^2) * 100, 1)

ggplot(plot_df, aes(x = x, y = y, color = type, shape = type)) +
  geom_hline(yintercept = 0, color = "grey70") +
  geom_vline(xintercept = 0, color = "grey70") +
  geom_point(size = 3) +
  geom_text_repel(aes(label = name), size = 4.2, show.legend = FALSE, seed = 1) +
  scale_color_manual(values = c("ブランド" = "#195379", "イメージ" = "#4D7A12")) +
  labs(title = "ブランドイメージのコレスポンデンス分析",
       x = paste0("第1軸(", inertia[1], "%)"), y = paste0("第2軸(", inertia[2], "%)"),
       color = NULL, shape = NULL)
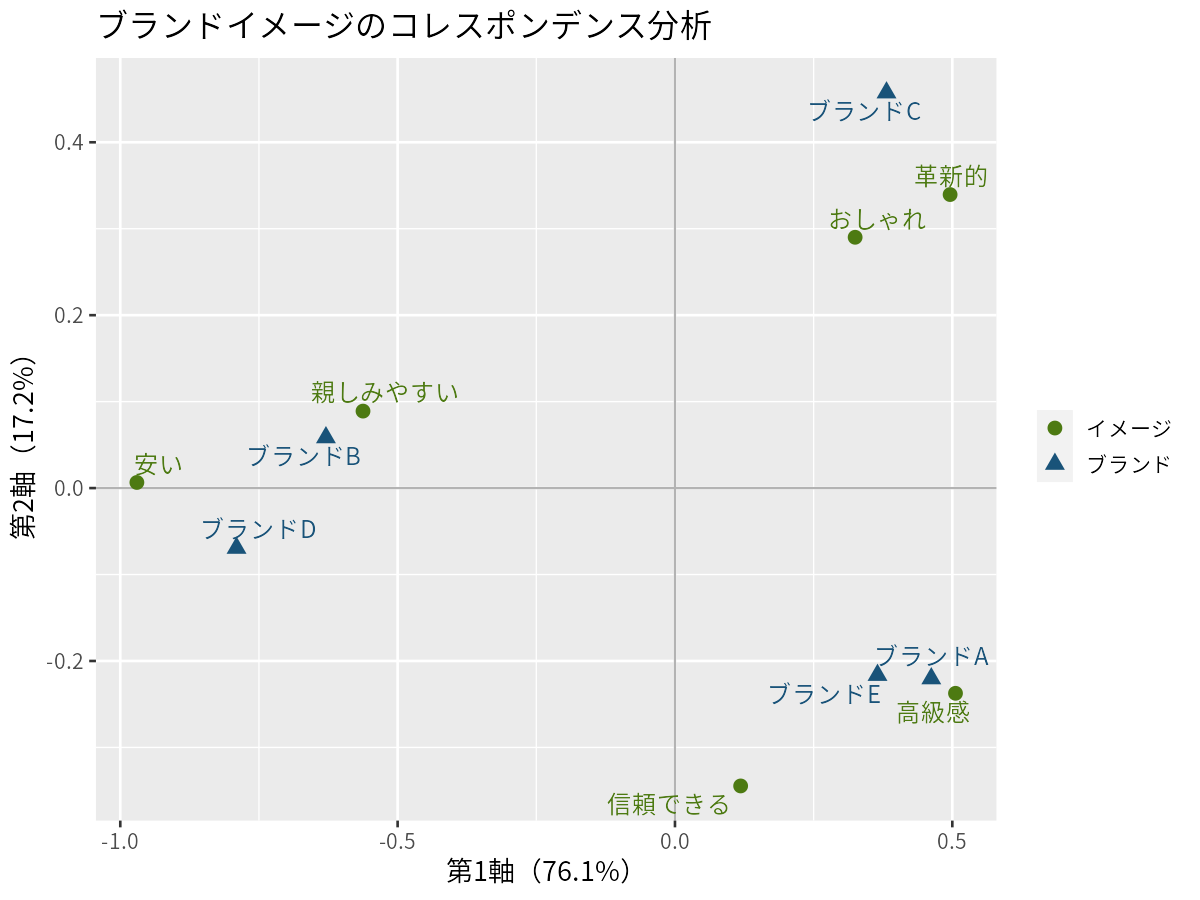
座標に res$sv(特異値)を掛けているのは、plot(res) の標準の描き方(対称マップ)に合わせるためです。記事の冒頭の図が、このコードで作ったマップです。
マップの読み方
軸の意味を考える
まず、それぞれの軸の両端にどんなイメージがあるかを見ます。
| 軸 | マイナス側 | プラス側 | 解釈 |
|---|---|---|---|
| 第1軸(横) | 安い・親しみやすい | 高級感・革新的・おしゃれ | 「手頃さ ⇔ プレミアム感」 |
| 第2軸(縦) | 信頼できる・高級感 | おしゃれ・革新的 | 「伝統・信頼 ⇔ 新しさ・トレンド」 |
ブランドの位置を読む
| ブランド | 位置 | 近いイメージ | ポジション |
|---|---|---|---|
| ブランドA・E | 右下 | 高級感・信頼できる | 信頼感のあるプレミアムブランド |
| ブランドC | 右上 | おしゃれ・革新的 | トレンド感のある新しいブランド |
| ブランドB・D | 左 | 安い・親しみやすい | 手頃で身近なブランド |
ブランドAとEは近い位置にあり、イメージが似ている=競合関係にあることがわかります。差別化を図るなら、どのイメージを強めるべきか、といった議論の材料になります。
読み取るときの注意点
- ブランドとイメージの距離は、厳密な比較ではない:対称マップでは、同じ種類どうし(ブランドとブランド、イメージとイメージ)の距離は解釈できますが、ブランドとイメージの距離はあくまで「方向が近いか」の目安です。
- 原点に近いものは特徴が弱い:原点付近にあるブランドは、どのイメージにも偏っていない「平均的な」ブランドです。
- 元の数字も必ず確認する:地図だけで判断せず、クロス集計表の数字と見比べて、解釈がずれていないかを確かめましょう。
まとめ
- コレスポンデンス分析は、クロス集計表を2次元の地図にする方法
ca(クロス集計表)で分析し、寄与率で地図の説明力を確認する- 軸の両端にあるイメージから、それぞれの軸の意味を解釈する
- 近くにあるブランドどうしは、イメージが似ている(競合している)
ブランドイメージ調査だけでなく、「年代×よく使うSNS」「エリア×よく売れる商品」など、さまざまなクロス集計表に応用できます。
同じことをGoogle ColabのPythonで行う方法は、Pythonでコレスポンデンス分析をする方法【ブランドイメージのポジショニングマップ】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。