
Rで基本統計量とクロス集計を出す方法【summary・table・prop.table】
 酒井 裕麻株式会社Bistro 代表取締役社長
アンケートや顧客データを受け取ったら、まずやるのが基本統計量とクロス集計です。「平均は?」「年代ごとの購入率は?」といった数字をつかむことで、データの全体像が見えてきます。
この記事では、Rで基本統計量を出す summary() や、クロス集計の table()・prop.table()・xtabs() の使い方を、アンケートデータを使って解説します。
参考記事
dplyrでデータ加工入門【filter・select・mutate・group_by・summarise】
ggplot2でグラフを作る方法【棒・折れ線・散布図と日本語の文字化け対策】
この記事で使うデータ
架空の商品アンケート survey.csv(400人分)を使います。
| 列名 | 内容 |
|---|---|
| id | 回答者ID |
| gender | 性別(男性・女性) |
| age | 年代(20代〜50代) |
| awareness | 商品の認知度(1〜5) |
| price_sat | 価格への満足度(1〜5) |
| ad_contact | 広告を見たか(1:見た、0:見ていない) |
| purchase | 購入したか(1:購入、0:非購入) |
| satisfaction | 総合満足度(0〜10) |
library(dplyr)
survey <- read.csv("survey.csv")
summary()で基本統計量をまとめて出す
summary(survey[, c("awareness", "price_sat", "satisfaction")])実行結果
   awareness      price_sat     satisfaction
 Min.   :1.00   Min.   :1.00   Min.   : 2.000
 1st Qu.:2.00   1st Qu.:2.75   1st Qu.: 5.000
 Median :3.00   Median :3.00   Median : 6.000
 Mean   :3.15   Mean   :3.18   Mean   : 6.133
 3rd Qu.:4.00   3rd Qu.:4.00   3rd Qu.: 7.000
Max. :5.00 Max. :5.00 Max. :10.000 | 表示 | 意味 |
|---|---|
| Min. / Max. | 最小値/最大値 |
| 1st Qu. | 第1四分位数(小さい方から25%の位置) |
| Median | 中央値(ちょうど真ん中の値) |
| Mean | 平均値 |
| 3rd Qu. | 第3四分位数(小さい方から75%の位置) |
平均・中央値・標準偏差を個別に出す
mean(survey$satisfaction); median(survey$satisfaction); sd(survey$satisfaction)[1] 6.1325
[1] 6
[1] 1.600421標準偏差(sd)は、データのばらつきの大きさです。満足度は平均6.1点で、多くの人がおおむね±1.6点の範囲に収まっている、と読み取れます。
table()で度数を数える
年代ごとの回答者数を数えます。
table(survey$age)20代 30代 40代 50代
114 104 105 77 prop.table()で構成比(%)にする
round(prop.table(table(survey$age)) * 100, 1)20代 30代 40代 50代
28.5 26.0 26.2 19.2 prop.table() で割合にし、100を掛けて round() で小数第1位に丸めています。
クロス集計
2つの項目を掛け合わせる
table() に2つの列を渡すと、クロス集計表になります。性別×購入の有無を集計してみましょう。
table(survey$gender, survey$purchase)
         0   1
  女性 117  68
  男性 137  78
行ごとの割合(購入率)を出す
クロス集計では、どの方向の割合を見るかが大切です。prop.table() の margin = 1 で行ごと(性別ごと)の割合になります。
round(prop.table(table(survey$gender, survey$purchase), margin = 1) * 100, 1)実行結果
          0    1
  女性 63.2 36.8
  男性 63.7 36.3
購入率は女性36.8%、男性36.3%で、ほとんど差がありませんでした。
| margin | 意味 |
|---|---|
margin = 1 |
行ごとの割合(行の合計が100%) |
margin = 2 |
列ごとの割合(列の合計が100%) |
| 指定なし | 全体に対する割合 |
xtabs():列名で書けるクロス集計
xtabs() を使うと、~ 行 + 列 の形で書けて、表の見出しに列名も表示されます。
xtabs(~ age + purchase, data = survey) purchase
age 0 1
20代 67 47
30代 64 40
40代 66 39
50代 57 20dplyrでまとめて集計する
人数・購入率・平均満足度を、年代ごとに1つの表で出したいときは、dplyrが便利です。0と1の列は、平均を取るとそのまま「1の割合」になります。
survey %>%
  group_by(age) %>%
  summarise(
    n = n(),
    purchase_rate = round(mean(purchase) * 100, 1),
    avg_satisfaction = round(mean(satisfaction), 2)
  )
実行結果
# A tibble: 4 × 4
  age       n purchase_rate avg_satisfaction
  <chr> <int>         <dbl>            <dbl>
1 20代    114          41.2             6.27
2 30代    104          38.5             6.1
3 40代    105          37.1             6.3
4 50代     77          26               5.75
50代は購入率が26.0%と、ほかの年代より低いことがわかります。
集計結果をグラフにする
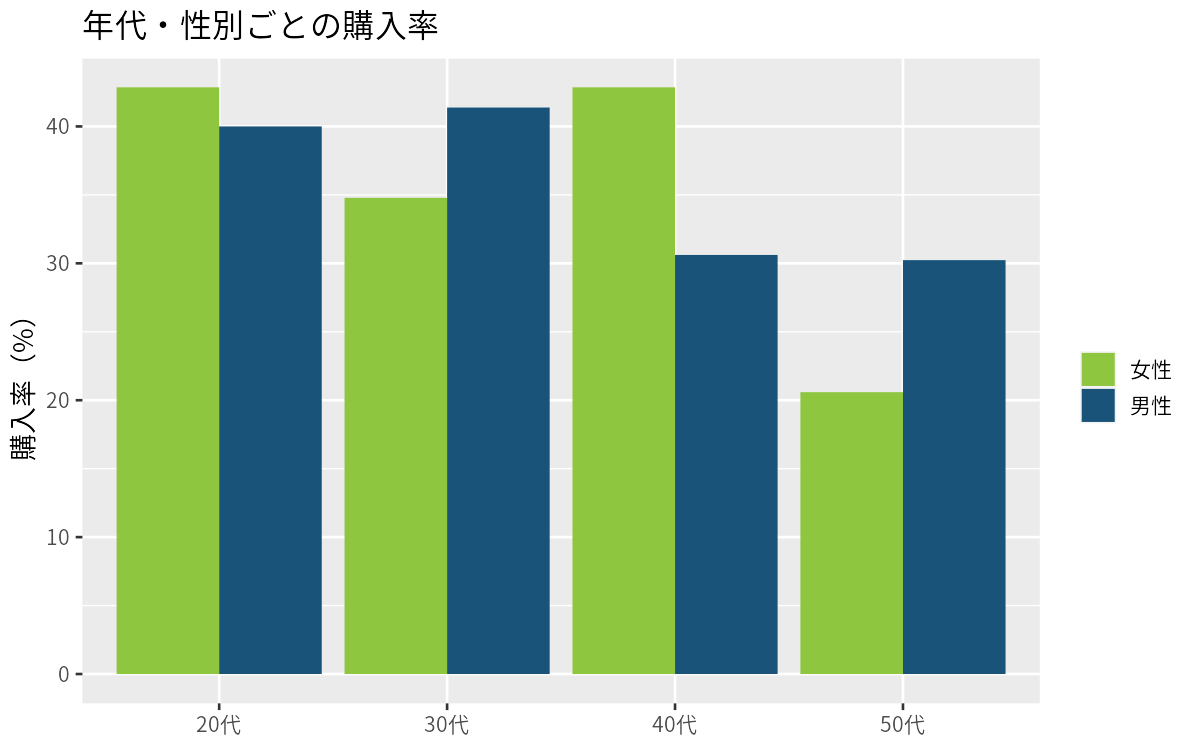
年代×性別の購入率を棒グラフにしたのが、記事の冒頭の図です。
library(ggplot2)
theme_set(theme_gray(base_family = "Meiryo"))  # Macは "Hiragino Sans"

survey %>%
  group_by(age, gender) %>%
  summarise(rate = mean(purchase) * 100) %>%
  ggplot(aes(x = age, y = rate, fill = gender)) +
  geom_col(position = "dodge") +
  scale_fill_manual(values = c("女性" = "#8FC63F", "男性" = "#195379")) +
labs(title = "年代・性別ごとの購入率", x = NULL, y = "購入率(%)", fill = NULL)グラフで見ると、30代と50代では男女の購入率に差があるようにも見えます。ただし、1つのグループの人数は数十人ずつなので、この差が偶然の範囲かどうかは、検定で確かめる必要があります。検定の方法は、t検定・カイ二乗検定の記事で解説します。
まとめ
summary()で最小値・四分位数・平均・最大値をまとめて確認できるtable()で度数、prop.table()で割合を出せる- クロス集計の割合は
margin = 1(行ごと)かmargin = 2(列ごと)かに注意 - 年代別の購入率などは、dplyrの
group_by()+summarise()で1つの表にまとめられる
基本統計量とクロス集計は、どんな分析でも最初に行う「データの健康診断」です。数字を眺めて、気になる差を見つけるところから分析を始めましょう。
同じことをGoogle ColabのPythonで行う方法は、Pythonで基本統計量とクロス集計を出す方法【pandasのdescribe・value_counts・crosstab】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。