
Rで決定木分析をする方法【rpartで購入者の特徴をルール化する】
 酒井 裕麻株式会社Bistro 代表取締役社長
「広告を見ていて、認知度が高い人は購入しやすい」──こうした「もし〜なら」のルールの形で、データの特徴を見つけ出してくれるのが決定木分析です。
結果が木の形の図で表されるので、統計に詳しくない人にも説明しやすく、マーケティングの現場で人気のある手法です。この記事では、Rの rpart パッケージを使った決定木分析のやり方と、結果の読み方を解説します。
参考記事
Rでロジスティック回帰分析をする方法【glm・オッズ比・購入確率の予測】
Rで基本統計量とクロス集計を出す方法【summary・table・prop.table】
決定木分析とは
決定木分析は、データを「購入者と非購入者が、最もきれいに分かれる条件」で次々に2つに分けていく方法です。
- すべての項目の中から、購入者と非購入者を最もよく分けられる条件を探す(例:広告を見たかどうか)
- 分けたそれぞれのグループで、さらに最もよく分けられる条件を探す
- これ以上分けても意味がないところで止める
こうしてできた分岐の流れが、木を逆さにしたような図になります。
この記事で使うデータ
架空の商品アンケート survey.csv(400人分)を使います。購入(purchase)を、認知度・価格満足度・広告接触・性別・年代で説明します。
install.packages("rpart")  # 最初の1回だけ(Rに標準で入っていることも多いです)
library(rpart)

survey <- read.csv("survey.csv")
survey$purchase <- factor(survey$purchase, labels = c("非購入", "購入"))
結果を読みやすくするため、購入の0/1を「非購入/購入」というラベルの因子(factor)にしています。
rpart()で決定木を作る
set.seed(1)
tree <- rpart(purchase ~ awareness + price_sat + ad_contact + gender + age,
              data = survey, method = "class",
              control = rpart.control(cp = 0.02, minbucket = 20))
print(tree)| 引数 | 意味 |
|---|---|
method = "class" |
分類(購入する/しないのようなカテゴリ)の木を作る |
cp |
分岐を続けるかどうかの基準。大きいほど木が小さく(シンプルに)なる |
minbucket |
最後のグループ(葉)に含める最低人数。小さすぎると、少人数のたまたまの傾向でルールができてしまう |
実行結果
n= 400

node), split, n, loss, yval, (yprob)
      * denotes terminal node

 1) root 400 146 非購入 (0.6350000 0.3650000)
   2) ad_contact< 0.5 220  57 非購入 (0.7409091 0.2590909) *
   3) ad_contact>=0.5 180  89 非購入 (0.5055556 0.4944444)
     6) awareness< 3.5 101  41 非購入 (0.5940594 0.4059406)
      12) price_sat< 3.5 54  15 非購入 (0.7222222 0.2777778) *
      13) price_sat>=3.5 47  21 購入 (0.4468085 0.5531915) *
     7) awareness>=3.5 79  31 購入 (0.3924051 0.6075949) *
結果の読み方
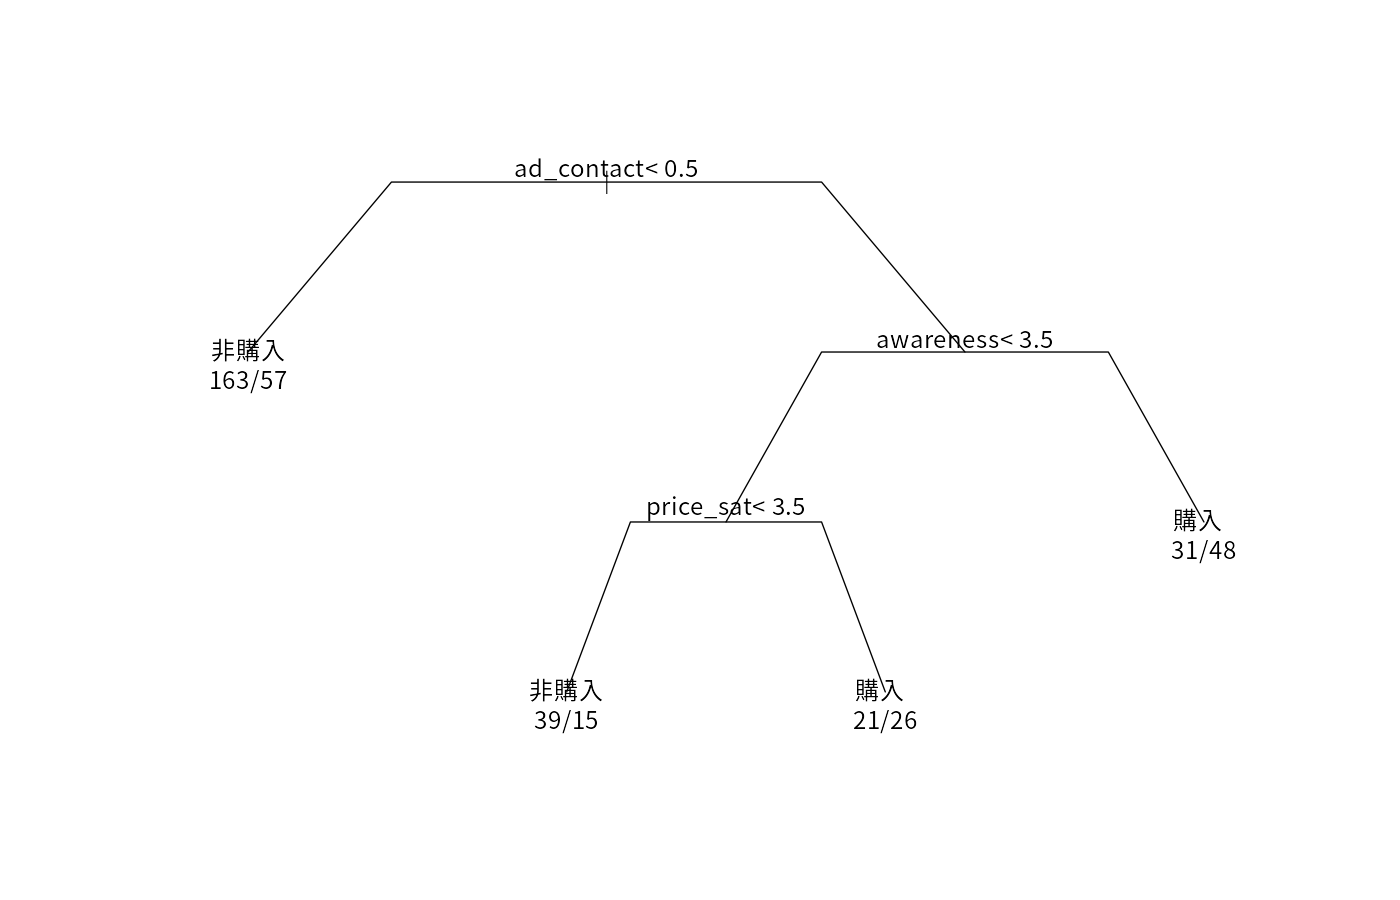
各行は「番号) 分岐の条件 人数 予測と違う人数 予測 (非購入の割合 購入の割合)」を表しています。* が付いた行が、最後のグループ(葉)です。
たとえば 7) awareness>=3.5 79 31 購入 (0.39 0.61) * は、「広告を見ていて、認知度が4以上の79人は、61%が購入している」という意味です。
これを整理すると、次のようなルールになります。
| 条件 | 人数 | 購入率 |
|---|---|---|
| 広告を見ていない | 220人 | 25.9% |
| 広告を見た & 認知度3以下 & 価格満足度3以下 | 54人 | 27.8% |
| 広告を見た & 認知度3以下 & 価格満足度4以上 | 47人 | 55.3% |
| 広告を見た & 認知度4以上 | 79人 | 60.8% |
全体の購入率36.5%に対して、「広告を見ていて、認知度が高い人」は6割以上が購入しています。また、広告を見ていて認知度がまだ低い人でも、価格に満足していれば購入率は55%まで上がることがわかります。
※ad_contact < 0.5 は「0(見ていない)」、awareness < 3.5 は「3以下」という意味です。数値の列は、値と値のちょうど間で区切られます。
決定木を図にする
plot(tree, uniform = TRUE, margin = 0.1, branch = 0.6)
text(tree, use.n = TRUE)記事の冒頭の図がこのコードで作った決定木です。各分岐で、条件に当てはまる場合は左、当てはまらない場合は右に進みます。葉の下の数字(use.n = TRUE)は、「非購入の人数/購入の人数」です。
※より見やすい図にしたい場合は、rpart.plot パッケージの rpart.plot(tree) を使うと、色分けされた図が1行で描けます。
変数の重要度
どの項目が分類に役立ったかは、variable.importance で確認できます。
tree$variable.importance実行結果
ad_contact  price_sat  awareness        age
 10.967475   3.934023   3.666062   0.973318
広告接触が最も重要で、価格満足度と認知度がそれに続きます。ロジスティック回帰分析で有意になった3つの項目と同じ結果です。
予測の精度を確認する
pred <- predict(tree, type = "class")
table(実際 = survey$purchase, 予測 = pred)
round(mean(pred == survey$purchase), 3)
実行結果
        予測
実際   非購入 購入
  非購入    202   52
  購入       72   74

[1] 0.69正解率は69.0%で、ロジスティック回帰(69.5%)とほぼ同じでした。決定木は精度ではわずかに劣ることがありますが、ルールがそのまま施策に結びつけやすいのが強みです。
決定木を使うときの注意点
- 木を大きくしすぎない:
cpを小さくすると細かいルールがたくさんできますが、手元のデータに合わせすぎて(過学習)、新しいデータでは当たらなくなります。 - 結果は少しのデータの違いで変わりやすい:データを入れ替えると、分岐の順番が変わることがあります。大事な判断に使う前に、別の期間のデータなどで確認しましょう。
- ランダムフォレストへの発展:決定木をたくさん作って多数決をとる「ランダムフォレスト」を使うと、精度と安定性が上がります。
まとめ
rpart(目的 ~ 説明変数, data = データ, method = "class")で決定木を作るprint()で分岐のルール、plot()とtext()で木の図を確認できる- 結果は「〜で、〜なら、購入率○%」というルールとして読み取れる
cpやminbucketで、木の大きさを調整する
決定木は「どんな人を狙えばいいか」をチームで話し合うときの、わかりやすい材料になります。ロジスティック回帰と組み合わせて使うのもおすすめです。
同じことをGoogle ColabのPythonで行う方法は、Pythonで決定木分析をする方法【scikit-learnで購入者の特徴をルール化する】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。