
Pythonで決定木分析をする方法【scikit-learnで購入者の特徴をルール化する】
 酒井 裕麻株式会社Bistro 代表取締役社長
「どんな人が商品を購入しているのか」を、「広告を見ていて、かつ認知度が高い人」のような、わかりやすいルールで表せたら便利ですよね。それを自動で見つけてくれるのが決定木分析です。
この記事では、Google ColabのPython(scikit-learn)で決定木分析を行い、購入者の特徴をルールとして読み取る方法を解説します。
同じ分析をRで行う方法は、Rで決定木分析をする方法で紹介しています。
決定木分析とは
決定木分析は、データを「はい・いいえ」で答えられる条件で、次々に2つに分けていく分析です。分けた結果が木の枝のように広がることから、決定木と呼ばれます。
| 特徴 | 内容 |
|---|---|
| わかりやすい | 結果が「〇〇で、かつ△△の人は購入率が高い」というルールで表せる |
| 準備が楽 | 数値の大きさをそろえる(標準化)などの下準備がいらない |
| 組み合わせを見つけられる | 「広告を見た人の中では、認知度が効く」のような、要因の組み合わせがわかる |
この記事で使うデータ
架空の商品アンケート survey.csv(400人分)を使い、購入したか(purchase)を、認知度・価格満足度・広告接触・性別・年代で説明します。
import pandas as pd
survey = pd.read_csv("https://www.bistro.business/files/r/survey.csv")scikit-learnでは、性別や年代のような文字の列は、そのままでは使えません。pd.get_dummies() で、0と1の列(ダミー変数)に変換します。
X = pd.get_dummies(
    survey[["awareness", "price_sat", "ad_contact", "gender", "age"]], drop_first=True, dtype=int
)
y = survey["purchase"]
X.head(3)
実行結果
   awareness  price_sat  ad_contact  gender_男性  age_30代  age_40代  age_50代
0          4          3           0          0        0        1        0
1          3          1           1          0        0        0        1
2          4          3           1          1        0        0        0
gender_男性 は男性なら1、age_30代 は30代なら1、という列です。drop_first=True で、基準となる1つ(女性、20代)の列を省いています。
DecisionTreeClassifierで決定木を作る
scikit-learnの DecisionTreeClassifier で決定木を作ります。scikit-learnはColabに最初から入っています。
from sklearn.tree import DecisionTreeClassifier

tree = DecisionTreeClassifier(min_samples_leaf=20, ccp_alpha=0.008, random_state=1)
tree.fit(X, y)
tree.get_n_leaves()
実行結果
np.int64(6)| 設定 | 意味 |
|---|---|
min_samples_leaf=20 |
最後のグループ(葉)は、最低20人以上にする |
ccp_alpha=0.008 |
小さすぎる分岐を刈り込む強さ。大きくするほど、木が単純になる |
random_state=1 |
結果を毎回同じにするための設定 |
決定木は、何も制限しないと、データにぴったり合うまで細かく分かれ続け、ルールが複雑になりすぎます(過学習)。min_samples_leaf や ccp_alpha、max_depth(深さの上限)で、木の大きさを調整します。今回は、6つのグループに分かれました。
結果の読み方
export_text() で、分岐のルールを文字で表示できます。
from sklearn.tree import export_text
print(export_text(tree, feature_names=list(X.columns), show_weights=True))
実行結果
|--- ad_contact <= 0.50
|   |--- awareness <= 4.50
|   |   |--- price_sat <= 3.50
|   |   |   |--- weights: [101.00, 18.00] class: 0
|   |   |--- price_sat >  3.50
|   |   |   |--- weights: [50.00, 26.00] class: 0
|   |--- awareness >  4.50
|   |   |--- weights: [12.00, 13.00] class: 1
|--- ad_contact >  0.50
|   |--- awareness <= 3.50
|   |   |--- price_sat <= 3.50
|   |   |   |--- weights: [39.00, 15.00] class: 0
|   |   |--- price_sat >  3.50
|   |   |   |--- weights: [21.00, 26.00] class: 1
|   |--- awareness >  3.50
|   |   |--- weights: [31.00, 48.00] class: 1
weights: [非購入の人数, 購入の人数] が、そのグループの人数で、class が予測(1:購入、0:非購入)です。ad_contact <= 0.50 は「0(見ていない)」、awareness <= 3.50 は「3以下」という意味です。数値の列は、値と値のちょうど間で区切られます。
これを整理すると、次のようなルールになります。
| 条件 | 人数 | 購入率 |
|---|---|---|
| 広告を見ていない & 認知度4以下 & 価格満足度3以下 | 119人 | 15.1% |
| 広告を見ていない & 認知度4以下 & 価格満足度4以上 | 76人 | 34.2% |
| 広告を見ていない & 認知度5 | 25人 | 52.0% |
| 広告を見た & 認知度3以下 & 価格満足度3以下 | 54人 | 27.8% |
| 広告を見た & 認知度3以下 & 価格満足度4以上 | 47人 | 55.3% |
| 広告を見た & 認知度4以上 | 79人 | 60.8% |
全体の購入率36.5%に対して、「広告を見ていて、認知度が高い人」は6割以上が購入しています。また、広告を見ていて認知度がまだ低い人でも、価格に満足していれば購入率は55%まで上がることがわかります。一方、広告を見ておらず、価格にも満足していない人の購入率は15%にとどまります。
決定木を図にする
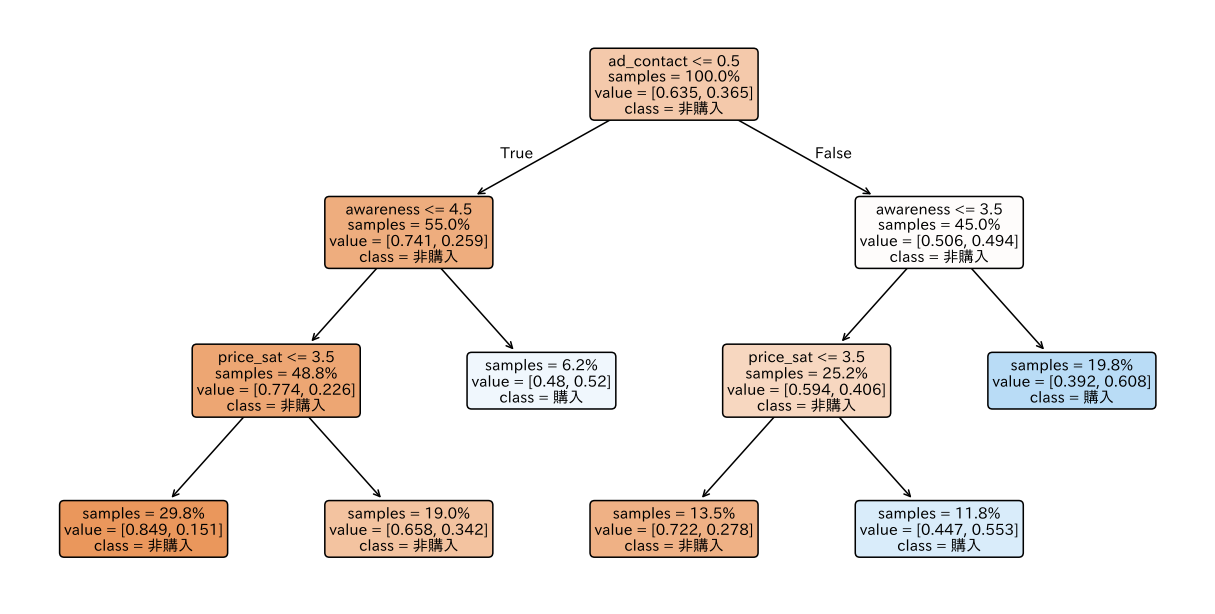
plot_tree() で、決定木を図にできます。日本語が文字化けしないように、matplotlib-fontja を読み込んでおきます。
!pip install -q matplotlib-fontjaimport matplotlib.pyplot as plt
import matplotlib_fontja
from sklearn.tree import plot_tree
fig, ax = plt.subplots(figsize=(14, 7))
plot_tree(tree, feature_names=list(X.columns), class_names=["非購入", "購入"],
filled=True, rounded=True, impurity=False, proportion=True, fontsize=10, ax=ax)
plt.show()
矢印の「True」は条件に当てはまる側(左)、「False」は当てはまらない側(右)です。proportion=True で、各グループの人数の割合(samples)と、非購入・購入の割合(value)を表示しています。色が濃いオレンジほど非購入、濃い青ほど購入の割合が高いグループです。
変数の重要度
feature_importances_ で、どの変数が分岐にどれくらい役立ったかを確認できます。
pd.Series(tree.feature_importances_, index=X.columns).sort_values(ascending=False).round(3)実行結果
ad_contact    0.428
awareness     0.291
price_sat     0.281
gender_男性     0.000
age_30代       0.000
age_40代       0.000
age_50代       0.000
dtype: float64広告接触が最も重要で、次いで認知度、価格満足度の順でした。性別や年代は、今回の決定木では分岐に使われていません。ロジスティック回帰分析で、広告接触・認知度・価格満足度が有意だった結果とも一致しています。
予測の精度を確認する
作った決定木で、一人ひとりが購入するかを予測し、実際と比べます。
pred = tree.predict(X)
print(pd.crosstab(y, pred, rownames=["実際"], colnames=["予測"]))
print("正解率:", round((pred == y).mean(), 3))
実行結果
予測    0   1
実際
0   190  64
1    59  87
正解率: 0.692
正解率は約69%でした。
学習用とテスト用にデータを分ける
上の正解率は、決定木を作ったのと同じデータで測ったものなので、実際より高めに出ます。新しいデータでどれくらい当たるかを確かめるには、データを学習用とテスト用に分けて、テスト用のデータで正解率を測ります。
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=1, stratify=y)
tree2 = DecisionTreeClassifier(min_samples_leaf=20, ccp_alpha=0.008, random_state=1).fit(X_train, y_train)
print("学習用の正解率:", round(tree2.score(X_train, y_train), 3))
print("テスト用の正解率:", round(tree2.score(X_test, y_test), 3))
実行結果
学習用の正解率: 0.696
テスト用の正解率: 0.617データの70%で決定木を作り、残りの30%で正解率を測りました。テスト用の正解率は約62%で、学習用より低くなりました。新しいデータに対しては、6割程度の精度と考えるのが現実的です。学習用とテスト用で正解率が大きく違う場合は、木が複雑すぎる(過学習している)可能性があります。stratify=y は、学習用とテスト用で、購入者の割合をそろえるための設定です。
決定木を使うときの注意点
- データが少し変わると、木の形が大きく変わることがある:結果のルールは「傾向」として読み、1つの分岐の数値にこだわりすぎないようにしましょう
- 木を大きくしすぎない:細かく分けるほど、そのデータだけに当てはまるルール(過学習)になります
- 予測の精度を高めたいときは、ランダムフォレストなど:たくさんの決定木を組み合わせる方法(
RandomForestClassifier)は、精度は上がりますが、ルールとして読むことはできなくなります
まとめ
- 決定木分析は、データを条件で次々に2つに分け、わかりやすいルールを見つける方法
- scikit-learnの
DecisionTreeClassifierで作る。文字の列はpd.get_dummies()で変換する - ルールは
export_text()、図はplot_tree()で確認する - 木の大きさは
min_samples_leaf・ccp_alpha・max_depthで調整する - 予測の精度は、学習用とテスト用に分けて確認する
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。