
Pythonでロジスティック回帰分析をする方法【statsmodelsのlogit・オッズ比・購入確率の予測】
 酒井 裕麻株式会社Bistro 代表取締役社長
「購入した・しなかった」「解約した・継続した」のように、結果が2択のデータで、どの要因が結果に影響しているかを調べたいときに使うのが、ロジスティック回帰分析です。
この記事では、Google ColabのPython(statsmodels)で、ロジスティック回帰分析のやり方と、結果をビジネスの言葉に直すためのオッズ比の読み方、購入確率の予測までを解説します。
同じ分析をRで行う方法は、Rでロジスティック回帰分析をする方法で紹介しています。
なぜ普通の回帰分析ではダメなのか
購入した(1)・しなかった(0)を、普通の回帰分析(Pythonで回帰分析をする方法)で分析すると、予測値が1を超えたり、マイナスになったりします。「購入確率120%」では意味がありません。
ロジスティック回帰分析は、予測値が必ず0〜1(0%〜100%)の範囲に収まるように工夫した回帰分析です。結果を「購入する確率」として読めるのが特徴です。
この記事で使うデータ
架空の商品アンケート survey.csv(400人分)を使います。
| 列名 | 内容 |
|---|---|
| awareness | 商品の認知度(1〜5) |
| price_sat | 価格への満足度(1〜5) |
| ad_contact | 広告を見たか(1:見た、0:見ていない) |
| gender | 性別(男性・女性) |
| age | 年代(20代〜50代) |
| purchase | 購入したか(1:購入、0:非購入)← これを説明したい |
import pandas as pd
import numpy as np
import statsmodels.formula.api as smf

survey = pd.read_csv("https://www.bistro.business/files/r/survey.csv")
survey["purchase"].value_counts()
実行結果
purchase
0    254
1    146
Name: count, dtype: int64
400人中146人(36.5%)が購入しています。
logit()でロジスティック回帰を実行する
statsmodelsの logit() を使います。書き方は、普通の回帰分析の ols() とほぼ同じです。
model = smf.logit(
    "purchase ~ awareness + price_sat + ad_contact + C(gender) + C(age)", data=survey
).fit()
print(model.summary().tables[1])
実行結果
Optimization terminated successfully.
         Current function value: 0.577812
         Iterations 6
===================================================================================
                      coef    std err          z      P>|z|      [0.025      0.975]
-----------------------------------------------------------------------------------
Intercept          -3.6998      0.606     -6.103      0.000      -4.888      -2.512
C(gender)[T.男性]    -0.1000      0.228     -0.439      0.661      -0.547       0.347
C(age)[T.30代]      -0.1085      0.299     -0.362      0.717      -0.695       0.478
C(age)[T.40代]      -0.0831      0.300     -0.277      0.782      -0.672       0.506
C(age)[T.50代]      -0.5581      0.349     -1.597      0.110      -1.243       0.127
awareness           0.4295      0.103      4.171      0.000       0.228       0.631
price_sat           0.4484      0.114      3.925      0.000       0.224       0.672
ad_contact          1.0516      0.226      4.644      0.000       0.608       1.496
===================================================================================
最初に表示される「Optimization terminated successfully.」は、計算がうまく終わったという意味です。
| 列 | 意味 |
|---|---|
| coef | 係数。プラスなら購入しやすくなる、マイナスなら購入しにくくなる |
| P>|z| | p値。0.05より小さければ有意 |
| [0.025 0.975] | 係数の95%信頼区間 |
認知度(awareness)・価格満足度(price_sat)・広告接触(ad_contact)の3つは、p値が0.05を大きく下回り、購入に有意な影響があることがわかります。性別や年代は、ほかの条件をそろえると、購入に差があるとは言えませんでした。
ただし、ロジスティック回帰の係数は、そのままでは「どれくらい購入しやすくなるか」がわかりにくい値です。そこで、オッズ比に変換します。
オッズ比で影響の大きさを読む
係数を np.exp()(指数関数)で変換すると、オッズ比になります。
odds = pd.concat([np.exp(model.params), np.exp(model.conf_int())], axis=1)
odds.columns = ["オッズ比", "下限", "上限"]
odds.round(2)
実行結果
                 オッズ比    下限    上限
Intercept        0.02  0.01  0.08
C(gender)[T.男性]  0.90  0.58  1.41
C(age)[T.30代]    0.90  0.50  1.61
C(age)[T.40代]    0.92  0.51  1.66
C(age)[T.50代]    0.57  0.29  1.14
awareness        1.54  1.26  1.88
price_sat        1.57  1.25  1.96
ad_contact 2.86 1.84 4.46オッズ比は、「その要因が1増えると、購入のしやすさ(オッズ)が何倍になるか」を表します。
| 要因 | オッズ比 | 読み方 |
|---|---|---|
| ad_contact | 2.86 | 広告を見た人は、見ていない人に比べて、購入のオッズが約2.9倍 |
| price_sat | 1.57 | 価格満足度が1上がると、購入のオッズが約1.6倍 |
| awareness | 1.54 | 認知度が1上がると、購入のオッズが約1.5倍 |
| C(age)[T.50代] | 0.57 | 50代は20代に比べて0.57倍だが、信頼区間が1をまたぐので有意ではない |
オッズ比が1より大きければ購入しやすく、1より小さければ購入しにくいことを表します。信頼区間(下限〜上限)が1をまたいでいれば、有意な影響があるとは言えません。
※オッズは「購入する確率 ÷ 購入しない確率」です。確率が低いうちは、オッズ比は「確率が何倍になるか」に近い値になりますが、厳密には同じではありません。
一人ひとりの購入確率を予測する
predict() を使うと、一人ひとりの購入確率を計算できます。
survey["pred"] = model.predict(survey)
survey[["id", "awareness", "price_sat", "ad_contact", "purchase", "pred"]].head().round(3)
実行結果
   id  awareness  price_sat  ad_contact  purchase   pred
0   1          4          3           0         1  0.327
1   2          3          1           1         0  0.187
2   3          4          3           1         0  0.578
3   4          2          2           0         0  0.076
4   5          5          1           1         0  0.466
pred の列が、モデルで予測した購入確率です。たとえば、id 1の人は購入確率が約33%と予測されています。
条件を変えて予測する
「30代の女性で、価格満足度が3」の人について、認知度と広告接触によって購入確率がどう変わるかを予測してみましょう。
grid = pd.DataFrame(
    [(a, c) for c in [0, 1] for a in range(1, 6)], columns=["awareness", "ad_contact"]
).assign(price_sat=3, gender="女性", age="30代")
grid["prob"] = model.predict(grid) * 100
grid.pivot(index="awareness", columns="ad_contact", values="prob").round(1)
実行結果
ad_contact     0     1
awareness
1           11.6  27.2
2           16.7  36.5
3           23.6  46.9
4           32.2  57.6
5           42.2  67.6
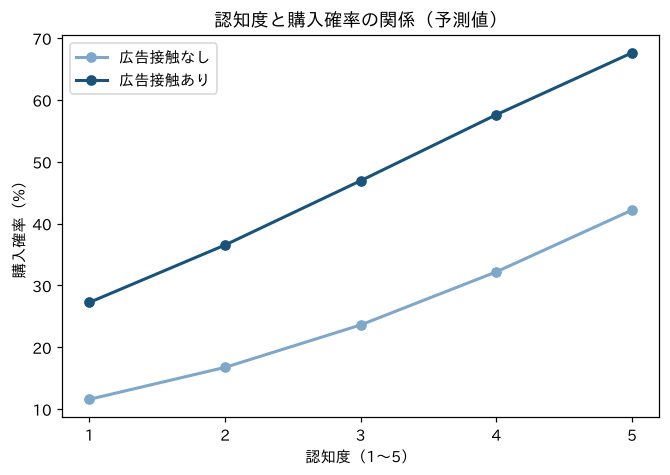
グラフにすると、違いがよくわかります。
!pip install -q matplotlib-fontjaimport matplotlib.pyplot as plt
import matplotlib_fontja
fig, ax = plt.subplots(figsize=(7, 4.5))
for c, color, label in [(0, "#7FA7C9", "広告接触なし"), (1, "#195379", "広告接触あり")]:
d = grid[grid["ad_contact"] == c]
ax.plot(d["awareness"], d["prob"], marker="o", linewidth=2, color=color, label=label)
ax.set_title("認知度と購入確率の関係(予測値)")
ax.set_xlabel("認知度(1〜5)")
ax.set_ylabel("購入確率(%)")
ax.set_xticks(range(1, 6))
ax.legend()
plt.show()
認知度が1から5に上がると、広告接触なしでは約12%から約42%に、広告接触ありでは約27%から約68%に、購入確率が上がると予測されます。「認知度を上げる施策」と「広告を届ける施策」を組み合わせると、効果が大きいことがわかります。
予測の精度を確認する
予測確率が50%以上の人を「購入する」と予測したとき、実際の購入とどれくらい合っているかを確認します。
survey["pred_class"] = (survey["pred"] >= 0.5).astype(int)
pd.crosstab(survey["purchase"], survey["pred_class"], rownames=["実際"], colnames=["予測"])
実行結果
予測    0   1
実際
0   215  39
1 83 63(survey["pred_class"] == survey["purchase"]).mean()実行結果
np.float64(0.695)正解率は約70%でした。ただし、実際に購入した146人のうち、「購入する」と予測できたのは63人だけです。ロジスティック回帰分析は、予測よりも、どの要因が購入に影響しているかを読み解くことに向いた方法です。
予測の精度を高めたいときは、決定木分析など、機械学習の方法もあわせて検討しましょう。
まとめ
- 結果が2択(購入した・しない)のデータには、ロジスティック回帰分析を使う
- statsmodels の
smf.logit("目的変数 ~ 説明変数", data=データ).fit()で実行する - 係数を
np.exp()でオッズ比に変換すると、影響の大きさを「何倍」で読める - オッズ比の信頼区間が1をまたいでいれば、有意な影響があるとは言えない
predict()で、条件ごとの購入確率を予測できる
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。