
Rでロジスティック回帰分析をする方法【glm・オッズ比・購入確率の予測】
 酒井 裕麻株式会社Bistro 代表取締役社長
「購入する/しない」「解約する/しない」「クリックする/しない」──マーケティングでは、2択の結果に何が影響しているかを知りたい場面がたくさんあります。
こうしたデータの分析に使うのがロジスティック回帰分析です。この記事では、Rの glm() でロジスティック回帰を行い、オッズ比で影響の大きさを読み取り、一人ひとりの購入確率を予測する方法を解説します。
参考記事
Rで回帰分析をする方法【lm関数・単回帰と重回帰・結果の読み方】
Rでt検定とカイ二乗検定をする方法【2つのグループの差は偶然?】
なぜ普通の回帰分析ではダメなのか
購入(1)/非購入(0)を、前回の記事の lm() でそのまま分析すると、予測値が「1.3」や「-0.2」のように、0〜1の範囲を超えてしまうことがあります。確率としては意味をなしません。
ロジスティック回帰は、予測値を必ず0〜1の確率に収まるように変換して分析する方法です。
この記事で使うデータ
架空の商品アンケート survey.csv(400人分)を使います。
survey <- read.csv("survey.csv")
table(survey$purchase)
  0   1
254 146
400人中146人(36.5%)が購入しています。この購入に、認知度(awareness:1〜5)、価格満足度(price_sat:1〜5)、広告接触(ad_contact:1/0)、性別(gender)、年代(age)がどう影響しているかを調べます。
glm()でロジスティック回帰を実行する
glm() に family = binomial を指定すると、ロジスティック回帰になります。書き方は lm() とほぼ同じです。
model <- glm(purchase ~ awareness + price_sat + ad_contact + gender + age,
             data = survey, family = binomial)
summary(model)
実行結果
Coefficients:
            Estimate Std. Error z value Pr(>|z|)
(Intercept) -3.69984    0.60627  -6.103 1.04e-09 ***
awareness    0.42949    0.10297   4.171 3.03e-05 ***
price_sat    0.44839    0.11424   3.925 8.68e-05 ***
ad_contact   1.05165    0.22648   4.644 3.43e-06 ***
gender男性  -0.10002    0.22806  -0.439    0.661
age30代     -0.10847    0.29929  -0.362    0.717
age40代     -0.08305    0.30036  -0.277    0.782
age50代     -0.55809    0.34945  -1.597    0.110
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

    Null deviance: 524.99  on 399  degrees of freedom
Residual deviance: 462.25  on 392  degrees of freedom
AIC: 478.25p値(Pr(>|z|))を見ると、認知度・価格満足度・広告接触の3つが有意(***)で、性別と年代は有意ではありませんでした。係数がプラスなら購入しやすくなる方向、マイナスなら購入しにくくなる方向です。
ただし、ロジスティック回帰の係数は「対数オッズ」という単位なので、そのままでは「どれくらい購入しやすくなるか」がわかりにくい、という難点があります。そこでオッズ比に変換します。
オッズ比で影響の大きさを読む
係数を exp() で変換すると、オッズ比になります。信頼区間もあわせて出しましょう。
odds <- exp(cbind(オッズ比 = coef(model), confint(model)))
round(odds, 2)
実行結果
            オッズ比 2.5 % 97.5 %
(Intercept)     0.02  0.01   0.08
awareness       1.54  1.26   1.89
price_sat       1.57  1.26   1.97
ad_contact      2.86  1.84   4.49
gender男性      0.90  0.58   1.41
age30代         0.90  0.50   1.61
age40代         0.92  0.51   1.66
age50代 0.57 0.28 1.13オッズとは、「購入する確率 ÷ 購入しない確率」のことです。オッズ比は、その項目が1増えたときにオッズが何倍になるかを表します。
| 項目 | オッズ比 | 読み方 |
|---|---|---|
| awareness | 1.54 | 認知度が1段階上がると、購入のオッズが1.54倍 |
| price_sat | 1.57 | 価格満足度が1段階上がると、購入のオッズが1.57倍 |
| ad_contact | 2.86 | 広告を見た人は、見ていない人に比べて購入のオッズが2.86倍 |
| gender男性 | 0.90 | 信頼区間が1をまたいでいる(0.58〜1.41)ので、有意な差はない |
| age50代 | 0.57 | 20代と比べて低めだが、信頼区間が1をまたいでいるので有意ではない |
オッズ比が1より大きければ購入しやすく、1より小さければ購入しにくい方向です。信頼区間が1をまたいでいれば、有意な影響があるとは言えません。
今回の結果からは、「広告に接触させること」が購入に最も大きく影響しており、次いで価格満足度と認知度を高めることが重要、と読み取れます。
一人ひとりの購入確率を予測する
predict() に type = "response" を指定すると、0〜1の購入確率が計算できます。
survey$pred <- predict(model, type = "response")
head(survey[, c("id", "awareness", "price_sat", "ad_contact", "purchase", "pred")], 5)
実行結果
  id awareness price_sat ad_contact purchase       pred
1  1         4         3          0        1 0.32744655
2  2         3         1          1        0 0.18703125
3  3         4         3          1        0 0.57808561
4  4         2         2          0        0 0.07570631
5 5 5 1 1 0 0.46620337たとえばid=3の人は、認知度4・価格満足度3・広告接触ありで、購入確率は約58%と予測されています。購入確率の高い順に並べれば、アプローチすべき見込み客のリストとして使うこともできます。
条件を変えて予測する
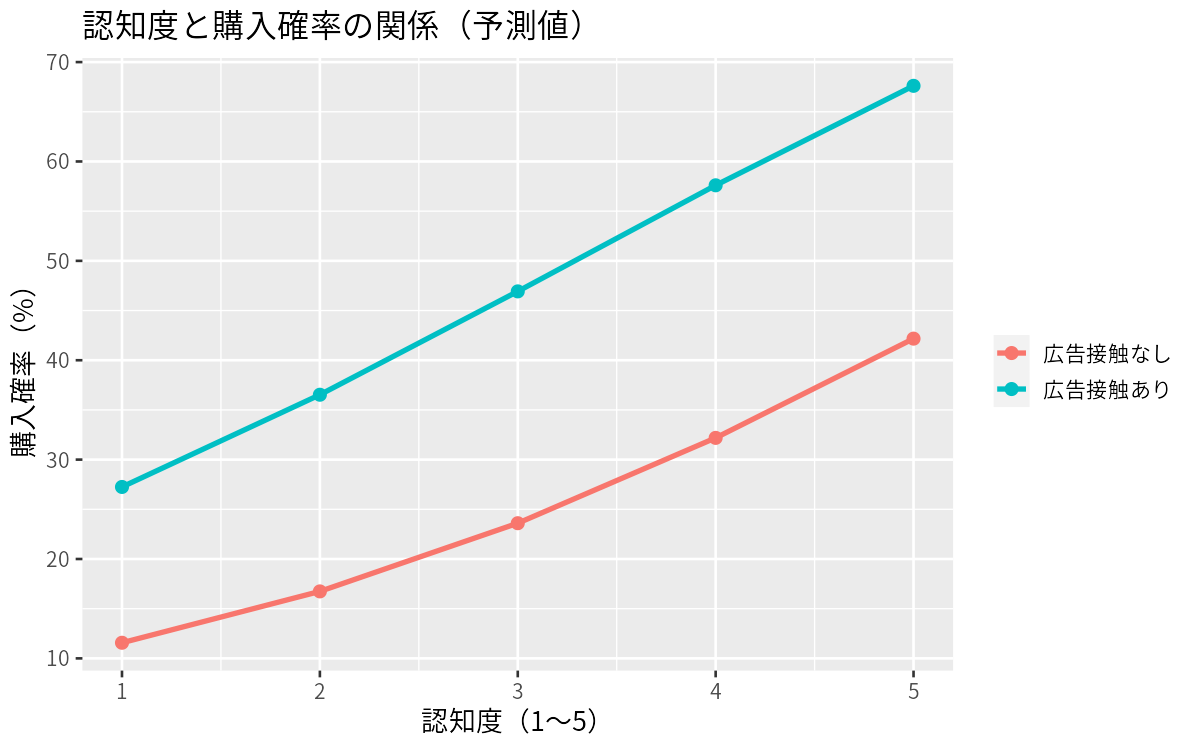
記事の冒頭のグラフは、「30代女性・価格満足度3」という条件で、認知度と広告接触の有無を変えたときの購入確率を予測したものです。
grid <- expand.grid(awareness = 1:5, price_sat = 3, ad_contact = c(0, 1),
                    gender = "女性", age = "30代")
grid$prob <- predict(model, newdata = grid, type = "response")

library(ggplot2)
theme_set(theme_gray(base_family = "Meiryo"))  # Macは "Hiragino Sans"

ggplot(grid, aes(x = awareness, y = prob * 100,
                 color = factor(ad_contact, labels = c("広告接触なし", "広告接触あり")))) +
  geom_line(linewidth = 1.2) + geom_point(size = 2.5) +
  labs(title = "認知度と購入確率の関係(予測値)", x = "認知度(1〜5)", y = "購入確率(%)", color = NULL)
expand.grid() は、指定した値のすべての組み合わせを作る関数です。認知度が高く、広告に接触している人ほど、購入確率が高くなることがひと目でわかります。
予測の精度を確認する
購入確率が0.5以上なら「購入する」と予測したとして、実際の結果と比べてみます。
pred_class <- ifelse(survey$pred >= 0.5, 1, 0)
table(実際 = survey$purchase, 予測 = pred_class)
mean(pred_class == survey$purchase)
実行結果
    予測
実際   0   1
   0 215  39
   1  83  63

[1] 0.695
400人中278人(215+63)を正しく予測でき、正解率は69.5%でした。ただし、実際に購入した146人のうち、正しく「購入する」と予測できたのは63人だけです。購入者を取りこぼしたくない場合は、判定の基準を0.5より低く(たとえば0.4に)する、といった調整も考えられます。
まとめ
- 2択の結果を分析するときは、
glm(..., family = binomial)でロジスティック回帰 - 係数はわかりにくいので、
exp()でオッズ比に変換して読む - オッズ比が1より大きければプラスの影響。信頼区間が1をまたいでいれば有意ではない
predict(..., type = "response")で、一人ひとりの確率を予測できる
ロジスティック回帰は、「どの施策が購入や成約に効いているか」を知るための強力な手法です。顧客データやアンケートデータで、ぜひ試してみてください。
同じことをGoogle ColabのPythonで行う方法は、Pythonでロジスティック回帰分析をする方法【statsmodelsのlogit・オッズ比・購入確率の予測】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。