
Rでt検定とカイ二乗検定をする方法【2つのグループの差は偶然?】
 酒井 裕麻株式会社Bistro 代表取締役社長
「広告を見た人のほうが、満足度が高い」「広告を見た人のほうが、購入率が高い」──集計結果に差が出たとき、それが本当に意味のある差なのか、たまたまの差なのかを判断するのが統計的検定です。
この記事では、マーケティングの分析でよく使う t検定(平均の差)とカイ二乗検定(割合の差)を、Rで実行する方法と結果の読み方を解説します。
参考記事
Rで基本統計量とクロス集計を出す方法【summary・table・prop.table】
Rでヒストグラムと箱ひげ図を作る方法【データの分布・外れ値の見方】
Rで相関分析をする方法【cor・cor.test・相関行列のヒートマップ】
どちらの検定を使う?
| 比べたいもの | データの例 | 検定 | Rの関数 |
|---|---|---|---|
| 2つのグループの平均 | 満足度(0〜10点)、購入金額 | t検定 | t.test() |
| 2つのグループの割合 | 購入した/しない、男性/女性 | カイ二乗検定 | chisq.test() |
比べたいのが「点数や金額のような数値」ならt検定、「はい/いいえのようなカテゴリ」ならカイ二乗検定、と覚えておきましょう。
p値の考え方
どちらの検定も、結果はp値で判断します。
- まず「2つのグループに差はない」と仮定する(帰無仮説)
- その仮定のもとで、今回のような差(またはそれ以上の差)が出る確率を計算する → これがp値
- p値が0.05より小さければ、「差がないのにこんな結果が出るのは珍しすぎる」と考え、差がある(統計的に有意)と判断する
この記事で使うデータ
架空の商品アンケート survey.csv(400人分)を使います。
library(dplyr)
survey <- read.csv("survey.csv")ad_contact(広告を見たか:1/0)、satisfaction(満足度:0〜10)、purchase(購入したか:1/0)、gender(性別)の列を使います。
t検定:満足度の平均に差はある?
まず、広告を見た人と見ていない人の満足度の平均を比べます。
survey %>%
  group_by(ad_contact) %>%
  summarise(n = n(), mean = round(mean(satisfaction), 2))
# A tibble: 2 × 3
ad_contact n mean
<int> <int> <dbl>
1 0 220 6.06
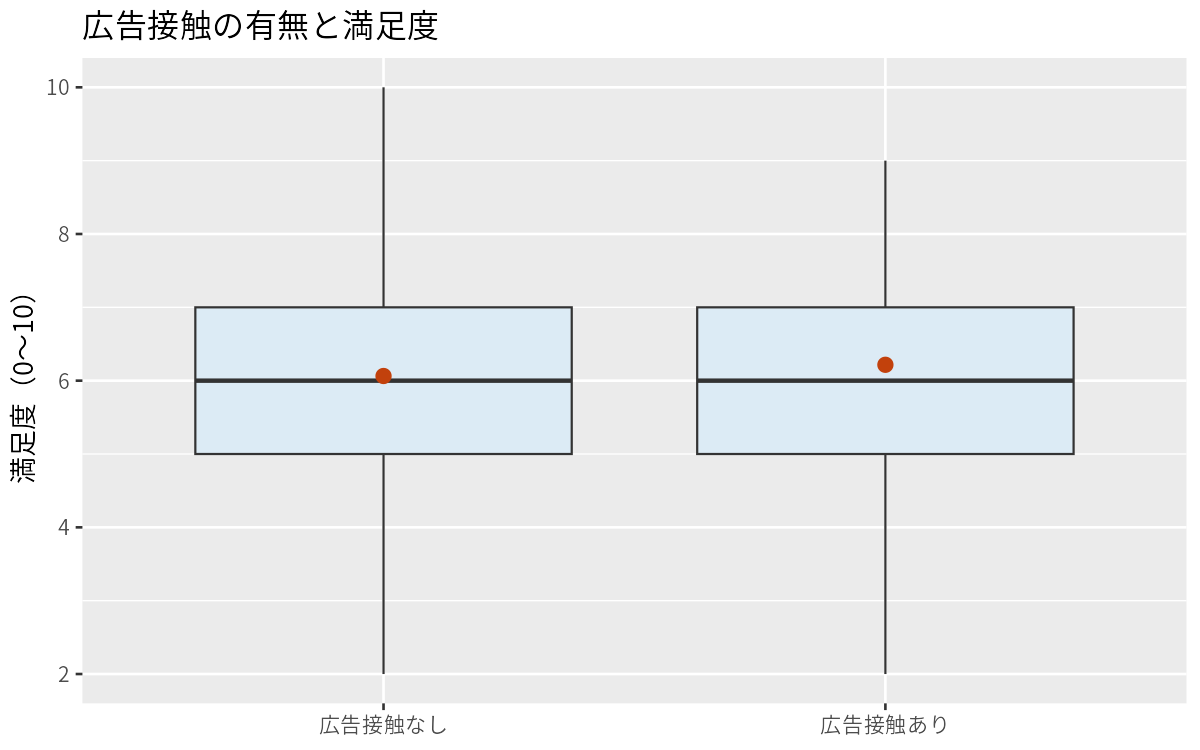
2 1 180 6.22広告を見た人(1)のほうが0.16点高くなっています。この差が意味のあるものか、t検定で確かめます。
t.test(satisfaction ~ ad_contact, data = survey)実行結果
	Welch Two Sample t-test

data:  satisfaction by ad_contact
t = -0.95129, df = 382.48, p-value = 0.3421
alternative hypothesis: true difference in means between group 0 and group 1 is not equal to 0
95 percent confidence interval:
 -0.4693232  0.1632626
sample estimates:
mean in group 0 mean in group 1
6.063636 6.216667 | 項目 | 読み方 |
|---|---|
| p-value = 0.3421 | 0.05より大きい → 差があるとは言えない |
| 95 percent confidence interval | 平均の差の範囲(-0.47〜0.16)。0をまたいでいるので、差が0の可能性を否定できない |
| sample estimates | それぞれのグループの平均 |
満足度 ~ グループ の形で書くと、グループごとに平均を比べてくれます。Rの t.test() は、標準で2つのグループのばらつきが違っていても使えるウェルチのt検定を行います。
記事の冒頭の箱ひげ図(オレンジの点が平均)を見ても、2つのグループの分布はほとんど重なっていることがわかります。
性別で比べた場合
t.test(satisfaction ~ gender, data = survey) Welch Two Sample t-test
data: satisfaction by gender
t = -0.40886, df = 393.13, p-value = 0.6829
...
sample estimates:
mean in group 女性 mean in group 男性
6.097297 6.162791 p値は0.68で、性別による満足度の差も見られませんでした。
カイ二乗検定:購入率に差はある?
次は、広告を見た人と見ていない人で購入率に差があるかを調べます。購入は「した/しない」のカテゴリなので、カイ二乗検定を使います。まずクロス集計表を作ります。
tab <- table(survey$ad_contact, survey$purchase)
tab
round(prop.table(tab, 1) * 100, 1)
実行結果
      0   1
  0 163  57
  1  91  89


       0    1
  0 74.1 25.9
  1 50.6 49.4
購入率は、広告を見ていない人が25.9%、見た人が49.4%です。このクロス集計表を chisq.test() に渡します。
chisq.test(tab)実行結果
	Pearson's Chi-squared test with Yates' continuity correction

data:  tab
X-squared = 22.655, df = 1, p-value = 1.938e-06
p値は 1.938e-06(=0.000001938)で、0.05を大きく下回りました。広告を見た人のほうが購入率が高いという差は、偶然とは考えにくい、と判断できます。
※e-06 は「×10のマイナス6乗」という意味です。
結果をどう読むか
今回の結果をまとめると、次のようになります。
| 比較 | 差 | p値 | 判断 |
|---|---|---|---|
| 広告接触 × 満足度 | 6.06点 → 6.22点 | 0.34 | 差があるとは言えない |
| 性別 × 満足度 | 6.10点 → 6.16点 | 0.68 | 差があるとは言えない |
| 広告接触 × 購入率 | 25.9% → 49.4% | 0.000002 | 有意な差がある |
「広告は購入を後押ししているが、満足度にはほとんど影響していない」という仮説が立てられます。
検定を使うときの注意点
- 「有意差なし」は「差がない」ことの証明ではない:あくまで「差があるとは言えない」という意味です。人数が少ないと、本当は差があっても有意にならないことがあります。
- 人数が多いと、小さな差でも有意になる:何万人ものデータでは、ビジネス上は意味のないわずかな差でもp値が小さくなります。差の大きさもあわせて見ましょう。
- 有意差は因果関係の証明ではない:広告を見た人は、もともと商品に興味がある人だった可能性もあります。ほかの要因の影響もあわせて考えるには、回帰分析が役立ちます。
- カイ二乗検定は人数が少ないと使えない:クロス集計表に期待される人数が5未満のマスがあると、警告が出ます。その場合は
fisher.test()(フィッシャーの正確検定)を使います。
まとめ
- 平均の差は
t.test(数値 ~ グループ, data = データ) - 割合の差は、クロス集計表を作って
chisq.test(表) - p値が0.05より小さければ「統計的に有意な差がある」
- p値だけでなく、差の大きさや人数もあわせて判断する
検定を使えるようになると、「なんとなく差がある気がする」から、「データで差があると言える」に変わり、レポートの説得力がぐっと増します。
同じことをGoogle ColabのPythonで行う方法は、Pythonでt検定とカイ二乗検定をする方法【scipyで2つのグループの差は偶然かを調べる】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。