
Pythonで相関分析をする方法【corr・pearsonr・相関行列のヒートマップ】
 酒井 裕麻株式会社Bistro 代表取締役社長
「価格に満足している人ほど、総合満足度も高いのでは?」——このような2つの項目の関係の強さを数字で表すのが、相関分析です。
この記事では、Google ColabのPythonで、相関係数の計算から、相関の検定、たくさんの項目の関係をまとめて見るヒートマップまでを、アンケートデータを使って解説します。
同じ分析をRで行う方法は、Rで相関分析をする方法で紹介しています。
相関係数とは
相関係数は、2つの項目の直線的な関係の強さを、-1から1までの数字で表したものです。
| 相関係数 | 関係の強さの目安 |
|---|---|
| 0.7 〜 1.0 | 強い正の相関(一方が大きいと、もう一方も大きい) |
| 0.4 〜 0.7 | 中程度の正の相関 |
| 0.2 〜 0.4 | 弱い正の相関 |
| -0.2 〜 0.2 | ほとんど相関がない |
| -1.0 〜 -0.2 | 負の相関(一方が大きいと、もう一方は小さい) |
この記事で使うデータ
架空の商品アンケート survey.csv(400人分)を使います。認知度・価格満足度は1〜5、広告接触・購入は0か1、総合満足度は0〜10の値です。
!pip install -q matplotlib-fontjaimport pandas as pd
import matplotlib.pyplot as plt
import matplotlib_fontja
import seaborn as sns
survey = pd.read_csv("https://www.bistro.business/files/r/survey.csv")corr()で相関係数を出す
価格満足度と総合満足度の相関係数を出してみましょう。pandasの corr() を使います。
survey["price_sat"].corr(survey["satisfaction"])実行結果
np.float64(0.469877492027927)相関係数は約0.47で、中程度の正の相関があります。価格に満足している人ほど、総合満足度も高い傾向がある、と読み取れます。
散布図で確認してみましょう。価格満足度は1〜5の整数なので、そのまま描くと点が重なってしまいます。少しだけ位置をずらして(ジッター)描きます。
import numpy as np
rng = np.random.default_rng(1)
x = survey["price_sat"] + rng.uniform(-0.2, 0.2, len(survey))
y = survey["satisfaction"] + rng.uniform(-0.2, 0.2, len(survey))

fig, ax = plt.subplots(figsize=(7, 4.5))
ax.scatter(x, y, alpha=0.4, color="#195379")
a, b = np.polyfit(survey["price_sat"], survey["satisfaction"], 1)
ax.plot([1, 5], [a * 1 + b, a * 5 + b], color="#C2410C", linewidth=2)
ax.set_title("価格満足度と総合満足度")
ax.set_xlabel("価格満足度(1〜5)")
ax.set_ylabel("総合満足度(0〜10)")
plt.show()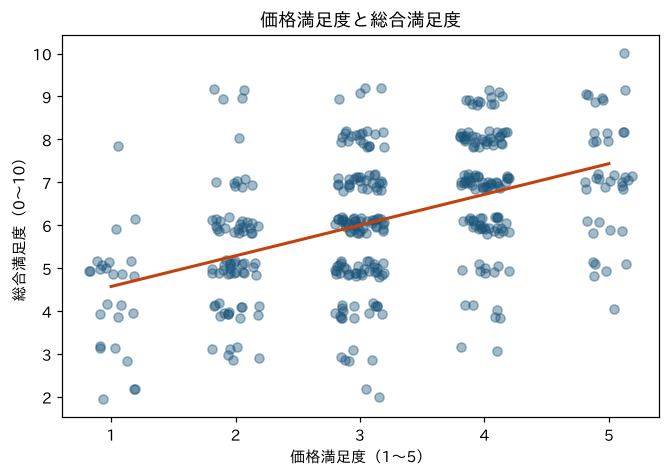
右上がりの傾向が見えます。
pearsonr()で相関の検定をする
相関係数が0.47と出ても、たまたまそうなっただけかもしれません。「本当は相関がない(相関係数が0)」と仮定して、今回の結果がどれくらい起こりにくいかを確かめるのが、相関の検定です。scipyの pearsonr() を使います。
from scipy import stats

result = stats.pearsonr(survey["price_sat"], survey["satisfaction"])
ci = result.confidence_interval(confidence_level=0.95)
print(f"相関係数: {result.statistic:.3f}")
print(f"p値: {result.pvalue:.2e}")
print(f"95%信頼区間: {ci.low:.3f} 〜 {ci.high:.3f}")
実行結果
相関係数: 0.470
p値: 2.32e-23
95%信頼区間: 0.390 〜 0.543| 項目 | 読み方 |
|---|---|
| 相関係数 | 0.47(中程度の正の相関) |
| p値 | 0.05を大きく下回る(e-23 は、小数点以下に0が22個並ぶとても小さな数)。偶然とは考えにくく、相関がある |
| 95%信頼区間 | 本当の相関係数は、0.39〜0.54の範囲にあると考えられる |
一般に、p値が0.05より小さければ「統計的に有意」と判断します。p値の考え方は、Pythonでt検定とカイ二乗検定をする方法でも解説しています。
相関行列:たくさんの項目をまとめて見る
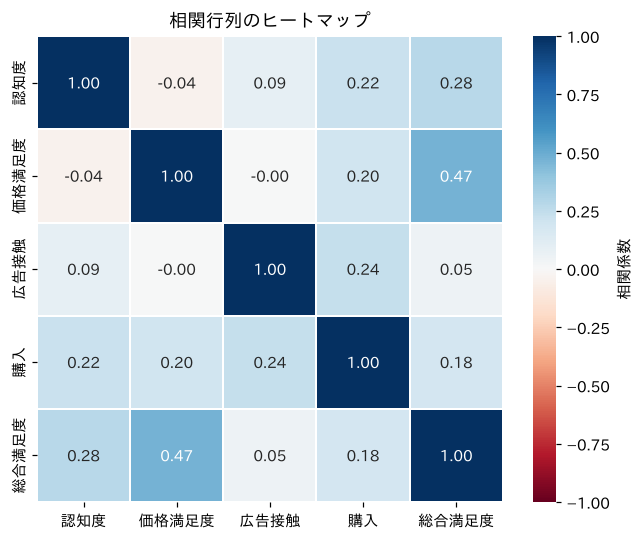
表全体に corr() を使うと、すべての項目の組み合わせの相関係数を、一度に出せます。これを相関行列と呼びます。
vars_ = survey[["awareness", "price_sat", "ad_contact", "purchase", "satisfaction"]]
vars_.columns = ["認知度", "価格満足度", "広告接触", "購入", "総合満足度"]
cm = vars_.corr().round(2)
cm
実行結果
        認知度  価格満足度  広告接触    購入  総合満足度
認知度    1.00  -0.04  0.09  0.22   0.28
価格満足度 -0.04   1.00 -0.00  0.20   0.47
広告接触   0.09  -0.00  1.00  0.24   0.05
購入     0.22   0.20  0.24  1.00   0.18
総合満足度  0.28   0.47  0.05  0.18   1.00
「購入」の行を見ると、広告接触(0.24)・認知度(0.22)・価格満足度(0.20)と、いずれも弱い正の相関があります。一方、総合満足度に強く関係しているのは価格満足度(0.47)で、広告接触(0.05)とはほぼ関係がありません。
0と1の項目(広告接触・購入)と、数値の項目との相関係数も、同じように計算できます(点双列相関と呼ばれます)。
ヒートマップで見やすくする
項目が多いと、数字の表では読み取りにくくなります。seabornの heatmap() で、相関の強さを色で表しましょう。
fig, ax = plt.subplots(figsize=(7, 5.5))
sns.heatmap(cm, annot=True, fmt=".2f", cmap="RdBu", vmin=-1, vmax=1, square=True,
            linewidths=1, cbar_kws={"label": "相関係数"}, ax=ax)
ax.set_title("相関行列のヒートマップ")
plt.show()
| 設定 | 意味 |
|---|---|
annot=True |
マスの中に数値を表示する |
cmap="RdBu" |
負の相関を赤、正の相関を青で表す |
vmin=-1, vmax=1 |
色の範囲を-1〜1に固定する(0を白にする) |
色の濃いマスを見れば、関係の強い組み合わせがすぐにわかります。
順位相関(スピアマン)
通常の相関係数(ピアソンの相関係数)は、外れ値の影響を受けやすく、直線的な関係しか捉えられません。満足度のような順序のある評価や、外れ値があるデータでは、順位相関(スピアマンの順位相関係数)も確認しておくと安心です。method="spearman" を指定します。
survey["price_sat"].corr(survey["satisfaction"], method="spearman")実行結果
np.float64(0.476949536950575)今回は通常の相関係数(0.47)とほぼ同じ値になりました。2つの値が大きく違う場合は、外れ値や、直線的ではない関係がないかを散布図で確認しましょう。検定もしたいときは、stats.spearmanr() を使います。
相関分析の注意点
- 相関があっても、原因と結果の関係(因果関係)があるとは限りません。 たとえば、アイスの売上と水難事故の数には相関がありますが、どちらも「気温が高い」ことが原因です
- 直線的ではない関係は、相関係数に表れません。 U字型の関係などは、散布図で確認しましょう
- データの件数が多いと、弱い相関でもp値は小さくなります。 「有意かどうか」だけでなく、相関係数の大きさも見ましょう
まとめ
- 相関係数は、2つの項目の直線的な関係の強さを-1〜1で表す
- 2つの列の相関係数は
s1.corr(s2)、表全体ならdf.corr() stats.pearsonr()で、相関が偶然ではないかを検定する(p値 < 0.05 で有意)- 相関行列は
sns.heatmap()で色を付けると読みやすい - 順序のある評価や外れ値があるときは、スピアマンの順位相関も確認する
相関分析は、「どの項目とどの項目が関係していそうか」のあたりをつけるのに最適です。気になる関係が見つかったら、回帰分析などでさらに深掘りしていきましょう。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。