
Rで分散分析(ANOVA)をする方法【3つ以上のグループの平均を比べる】
 酒井 裕麻株式会社Bistro 代表取締役社長
前回の記事では、2つのグループの平均を比べるt検定を紹介しました。では、「20代・30代・40代・50代」や「渋谷店・横浜店・新宿店」のように、3つ以上のグループを比べたいときはどうすればよいでしょうか。
そこで使うのが分散分析(ANOVA)です。この記事では、Rの aov() で分散分析を行い、TukeyHSD() で「どのグループ間に差があるか」まで調べる方法を解説します。
参考記事
Rでt検定とカイ二乗検定をする方法【2つのグループの差は偶然?】
Rでヒストグラムと箱ひげ図を作る方法【データの分布・外れ値の見方】
なぜt検定を繰り返してはいけないのか
3つの店舗を比べるなら、「渋谷と横浜」「渋谷と新宿」「横浜と新宿」の3回t検定をすればよい、と思うかもしれません。
しかし、検定を繰り返すと、どれか1つで偶然「有意」になってしまう確率がどんどん高くなります。1回の検定で間違える確率が5%でも、3回繰り返すとおよそ14%になってしまいます。
そこで、まず分散分析で「グループ全体として差があるか」を1回で確かめ、差があった場合に多重比較で「どこに差があるか」を調べる、という手順を踏みます。
例1:年代によって満足度は違う?
架空の商品アンケート survey.csv を使って、年代ごとの満足度を比べます。
library(dplyr)
survey <- read.csv("survey.csv")

survey %>%
  group_by(age) %>%
  summarise(n = n(), mean = round(mean(satisfaction), 2), sd = round(sd(satisfaction), 2))
実行結果
# A tibble: 4 × 4
  age       n  mean    sd
  <chr> <int> <dbl> <dbl>
1 20代    114  6.27  1.58
2 30代    104  6.1   1.66
3 40代    105  6.3   1.45
4 50代     77  5.75  1.7
50代だけ少し低いように見えます。分散分析で確かめてみましょう。
res <- aov(satisfaction ~ age, data = survey)
summary(res)
実行結果
             Df Sum Sq Mean Sq F value Pr(>F)
age           3   16.2   5.403   2.127 0.0962 .
Residuals   396 1005.8   2.540
---
Signif. codes: 0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1| 項目 | 意味 |
|---|---|
| Df | 自由度(グループ数-1、データ数-グループ数) |
| Sum Sq / Mean Sq | グループの違いで説明できるばらつき(age)と、説明できないばらつき(Residuals) |
| F value | グループ間のばらつきが、グループ内のばらつきの何倍か。大きいほど差がある |
| Pr(>F) | p値。0.05より小さければ、どこかのグループ間に差がある |
p値は0.0962で、0.05より大きい結果でした。50代は少し低めに見えますが、年代によって満足度に差があるとまでは言えません。
※行末の記号(. や *)は有意水準の目安です。. は「0.1未満」、* は「0.05未満」、*** は「0.001未満」を表します。
例2:店舗によって客数は違う?
次に、売上データ(sales.csv)の食品カテゴリで、店舗ごとの1日の客数を比べます。
sales <- read.csv("sales.csv")
food <- sales %>% filter(category == "食品")

res2 <- aov(customers ~ store, data = food)
summary(res2)
実行結果
             Df Sum Sq Mean Sq F value Pr(>F)
store         2 201677  100838     151 <2e-16 ***
Residuals   267 178310     668
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1
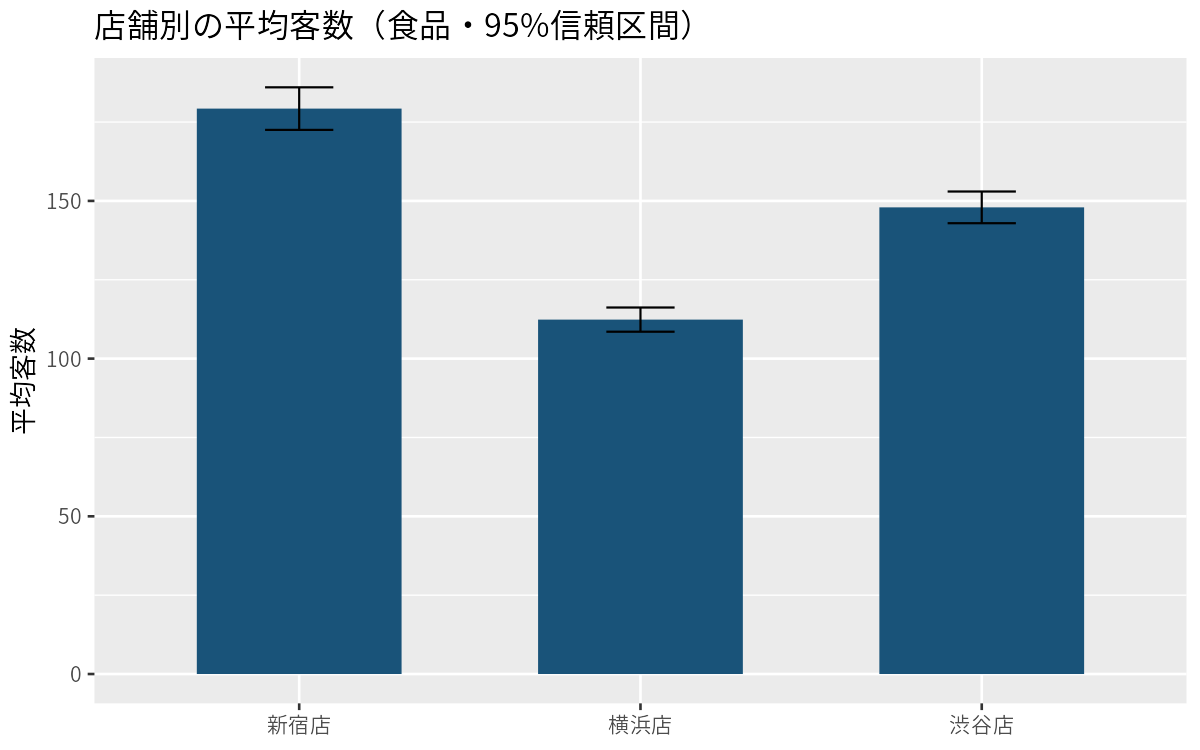
F値は151と非常に大きく、p値は 2e-16 未満です。店舗によって客数に差があることがわかりました。
TukeyHSD()で、どこに差があるかを調べる
分散分析でわかるのは「どこかに差がある」ということまでです。どの店舗とどの店舗に差があるのかは、多重比較の TukeyHSD() で調べます。
TukeyHSD(res2)実行結果
  Tukey multiple comparisons of means
    95% family-wise confidence level

Fit: aov(formula = customers ~ store, data = food)

$store
                   diff       lwr       upr p adj
横浜店-新宿店 -66.90000 -75.97946 -57.82054     0
渋谷店-新宿店 -31.31111 -40.39057 -22.23165     0
渋谷店-横浜店 35.58889 26.50943 44.66835 0| 列 | 意味 |
|---|---|
| diff | 平均の差(例:横浜店は新宿店より1日あたり66.9人少ない) |
| lwr / upr | 差の95%信頼区間。0をまたいでいなければ有意 |
| p adj | 繰り返しの比較を考慮して調整したp値 |
3つの組み合わせすべてで p adj が0(きわめて小さい)となり、新宿店 > 渋谷店 > 横浜店の順に、どの店舗間にも客数の差があることがわかりました。
記事の冒頭のグラフは、店舗ごとの平均客数に95%信頼区間のエラーバーを付けたものです。エラーバーどうしが離れているほど、差がはっきりしていることを表します。
library(ggplot2)
theme_set(theme_gray(base_family = "Meiryo"))  # Macは "Hiragino Sans"

food %>%
  group_by(store) %>%
  summarise(m = mean(customers), se = sd(customers) / sqrt(n())) %>%
  ggplot(aes(x = store, y = m)) +
  geom_col(fill = "#195379", width = 0.6) +
  geom_errorbar(aes(ymin = m - 1.96 * se, ymax = m + 1.96 * se), width = 0.2) +
  labs(title = "店舗別の平均客数(食品・95%信頼区間)", x = NULL, y = "平均客数")
グループのばらつきが違うとき
aov() は、「どのグループもばらつき(分散)が同じくらい」という前提で計算します。グループによってばらつきが大きく違う場合は、その前提がいらないウェルチの分散分析 oneway.test() を使うと安心です。
oneway.test(customers ~ store, data = food)実行結果
	One-way analysis of means (not assuming equal variances)

data:  customers and store
F = 161.55, num df = 2.00, denom df = 169.83, p-value < 2.2e-16
こちらでも、店舗間に有意な差があるという結果になりました。
まとめ
- 3つ以上のグループの平均を比べるときは、t検定の繰り返しではなく分散分析
summary(aov(数値 ~ グループ, data = データ))で、全体として差があるかを確認- 差があったら
TukeyHSD()で、どのグループ間に差があるかを調べる - グループごとのばらつきが違うときは
oneway.test()
分散分析は、店舗・エリア・キャンペーンの種類など、マーケティングで「複数のパターンを比べたい」場面で幅広く使えます。
同じことをGoogle ColabのPythonで行う方法は、Pythonで分散分析(ANOVA)をする方法【3つ以上のグループの平均を比べる・Tukeyの多重比較】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。