
Pythonで分散分析(ANOVA)をする方法【3つ以上のグループの平均を比べる・Tukeyの多重比較】
 酒井 裕麻株式会社Bistro 代表取締役社長
「年代によって満足度は違うのか」「3つの店舗で客数に差があるのか」——3つ以上のグループの平均を比べたいときに使うのが、分散分析(ANOVA)です。
この記事では、Google ColabのPythonで分散分析を行う方法と、差があったときにどのグループの間に差があるのかを調べる多重比較の方法を解説します。
同じ分析をRで行う方法は、Rで分散分析(ANOVA)をする方法で紹介しています。
なぜt検定を繰り返してはいけないのか
3つのグループを比べるとき、「AとB」「AとC」「BとC」の3回、t検定を繰り返せばよいと思うかもしれません。
しかし、検定を繰り返すと、どれか1つで偶然「有意」になってしまう確率がどんどん高くなります。1回の検定で間違える確率が5%でも、3回繰り返すとおよそ14%になってしまいます。
分散分析なら、「どこかのグループの間に差があるか」を、1回の検定で調べられます。2つのグループの比較(t検定)については、Pythonでt検定とカイ二乗検定をする方法をご覧ください。
例1:年代によって満足度は違う?
架空の商品アンケート survey.csv(400人分)を使って、年代(20代〜50代)によって総合満足度(0〜10)に差があるかを調べます。まずは、年代ごとの平均を確認します。
import pandas as pd
from scipy import stats

survey = pd.read_csv("https://www.bistro.business/files/r/survey.csv")
survey.groupby("age")["satisfaction"].agg(["count", "mean", "std"]).round(2)
実行結果
     count  mean   std
age
20代    114  6.27  1.58
30代    104  6.10  1.66
40代    105  6.30  1.45
50代     77  5.75  1.70
50代が少し低めに見えます。この差が偶然かどうかを、scipyの f_oneway() で調べます。グループごとのデータを、それぞれ渡します。
groups = [g["satisfaction"] for _, g in survey.groupby("age")]
result = stats.f_oneway(*groups)
print(f"F値: {result.statistic:.3f}")
print(f"p値: {result.pvalue:.4f}")
実行結果
F値: 2.127
p値: 0.0962
*groups は、リストの中身(4つの年代のデータ)を、ばらばらにして関数に渡す書き方です。
p値は0.0962で、0.05より大きい結果でした。50代は少し低めに見えますが、年代によって満足度に差があるとまでは言えません。
| 項目 | 意味 |
|---|---|
| F値 | グループ間の差が、グループ内のばらつきに比べてどれくらい大きいか。大きいほど差がある |
| p値 | 0.05より小さければ、どこかのグループの間に差がある |
statsmodelsで分散分析表を出す
statsmodelsを使うと、Rの summary(aov()) と同じ形の分散分析表を出せます。式の形(満足度 ~ 年代)で書けるのも、Rに近い書き方です。
import statsmodels.formula.api as smf
import statsmodels.api as sm

model = smf.ols("satisfaction ~ C(age)", data=survey).fit()
sm.stats.anova_lm(model, typ=2)
実行結果
               sum_sq     df         F    PR(>F)
C(age)      16.209556    3.0  2.127391  0.096222
Residual  1005.767944  396.0       NaN       NaN
C(age) は、年代を「カテゴリ(グループ)」として扱う、という意味です。PR(>F) の列がp値で、f_oneway() と同じ0.0962になっています。
例2:店舗によって客数は違う?
次は、売上データ sales.csv の食品カテゴリを使って、3店舗の1日あたりの客数を比べます。
sales = pd.read_csv("https://www.bistro.business/files/r/sales.csv")
food = sales.query("category == '食品'")

food.groupby("store")["customers"].agg(["count", "mean", "std"]).round(1)
実行結果
       count   mean   std
store
新宿店       90  179.3  32.7
横浜店       90  112.4  18.6
渋谷店       90  148.0  24.3
model2 = smf.ols("customers ~ C(store)", data=food).fit()
sm.stats.anova_lm(model2, typ=2)実行結果
                 sum_sq     df           F        PR(>F)
C(store)  201676.940741    2.0  150.994464  1.357982e-44
Residual  178310.322222  267.0         NaN           NaN
F値は151と非常に大きく、p値は 0.05を大きく下回っています(e-44 は、小数点以下に0が43個並ぶとても小さな数)。店舗によって客数に差があることがわかりました。
Tukeyの多重比較で、どこに差があるかを調べる
分散分析でわかるのは「どこかに差がある」ということまでです。どの店舗とどの店舗の間に差があるのかは、多重比較で調べます。代表的なのが、Tukey(テューキー)の方法です。
from statsmodels.stats.multicomp import pairwise_tukeyhsd

tukey = pairwise_tukeyhsd(food["customers"], food["store"])
print(tukey.summary())
実行結果
 Multiple Comparison of Means - Tukey HSD, FWER=0.05
=====================================================
group1 group2 meandiff p-adj  lower    upper   reject
-----------------------------------------------------
   新宿店    横浜店    -66.9   0.0 -75.9795 -57.8205   True
   新宿店    渋谷店 -31.3111   0.0 -40.3906 -22.2317   True
   横浜店    渋谷店  35.5889   0.0  26.5094  44.6683   True
-----------------------------------------------------| 列 | 意味 |
|---|---|
| group1 / group2 | 比べている2つのグループ |
| meandiff | 平均の差(group2 − group1) |
| p-adj | 繰り返しの比較を考慮して調整したp値 |
| lower / upper | 差の95%信頼区間。0をまたいでいなければ有意 |
| reject | 有意差があれば True |
3つの組み合わせすべてで reject が True になりました(p-adj の 0.0 は、とても小さい値が四捨五入されて表示されたものです)。新宿店・渋谷店・横浜店の順に客数が多く、どの店舗の間にも差があることがわかります。
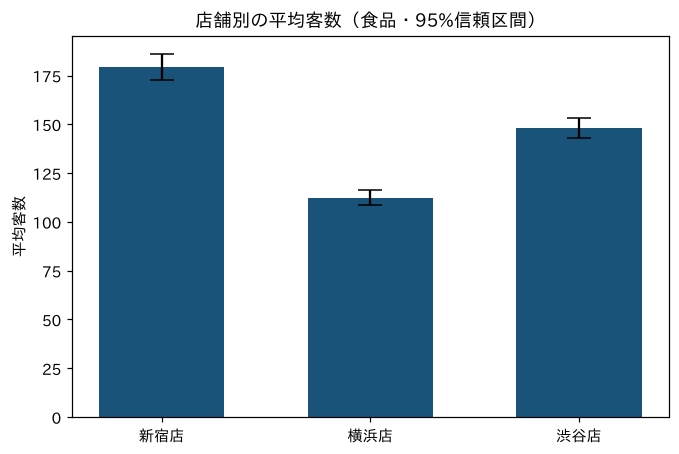
グラフで、平均と95%信頼区間を確認してみましょう。
!pip install -q matplotlib-fontjaimport numpy as np
import matplotlib.pyplot as plt
import matplotlib_fontja
summary = food.groupby("store")["customers"].agg(["mean", "std", "count"])
summary["se"] = summary["std"] / np.sqrt(summary["count"])
fig, ax = plt.subplots(figsize=(7, 4.5))
ax.bar(summary.index, summary["mean"], yerr=1.96 * summary["se"], capsize=8, color="#195379", width=0.6)
ax.set_title("店舗別の平均客数(食品・95%信頼区間)")
ax.set_ylabel("平均客数")
plt.show()
yerr で、エラーバー(ここでは平均の95%信頼区間)を付けています。エラーバーが重なっていないので、差がはっきりしていることがわかります。
グループのばらつきが違うとき
通常の分散分析は、どのグループもばらつき(分散)が同じくらいであることを前提にしています。グループによってばらつきが大きく違う場合は、ウェルチの分散分析を使います。
ばらつきが同じかどうかは、stats.levene()(ルビーン検定)で確認できます。
store_groups = [g["customers"] for _, g in food.groupby("store")]
stats.levene(*store_groups).pvalue
実行結果
np.float64(0.00010485940651468584)p値が0.05より小さく、店舗によってばらつきが違う結果になりました。そこで、statsmodelsの anova_oneway() で、ウェルチの分散分析を行います。
from statsmodels.stats.oneway import anova_oneway

welch = anova_oneway(food["customers"], groups=food["store"], use_var="unequal")
print(f"F値: {welch.statistic:.2f}")
print(f"p値: {welch.pvalue:.2e}")
実行結果
F値: 161.55
p値: 5.05e-40
こちらでも、店舗間に有意な差があるという結果になりました。Rの oneway.test() と同じ計算です。迷ったときは、ばらつきの違いに強いウェルチの分散分析を使っておくと安心です。
まとめ
- 3つ以上のグループの平均を比べるときは、t検定を繰り返さず、分散分析を使う
- 手軽に検定するなら
stats.f_oneway()、分散分析表は statsmodels のanova_lm() - どのグループ間に差があるかは
pairwise_tukeyhsd()(Tukeyの多重比較) - グループのばらつきが違うときは、
anova_oneway(..., use_var="unequal")(ウェルチの分散分析)
分散分析は、1つの要因(年代や店舗)の影響を調べる方法です。広告費や曜日など、複数の要因をまとめて考えるときは、Pythonで回帰分析をする方法をご覧ください。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。