
Rで日付データを扱う方法【lubridateで変換・曜日・月初・週単位の集計】
 酒井 裕麻株式会社Bistro 代表取締役社長
売上データやアクセスログには、必ずといっていいほど日付が入っています。「曜日ごとの客数を比べたい」「週単位で集計したい」と思っても、日付が文字のままだと計算ができません。
この記事では、日付の扱いをぐっと楽にしてくれる lubridate パッケージの使い方を、実行結果付きで解説します。
参考記事
RでCSVの文字化けを直す方法とExcelファイルの読み込み【実行結果付き】
dplyrでデータ加工入門【filter・select・mutate・group_by・summarise】
ggplot2でグラフを作る方法【棒・折れ線・散布図と日本語の文字化け対策】
lubridateの準備
install.packages("lubridate")  # 最初の1回だけ
library(lubridate)
library(dplyr)
文字の日付を日付型に変換する
ymd() は、「年(y)・月(m)・日(d)」の順に書かれた文字を日付型に変換します。区切り文字がバラバラでも、まとめて変換できるのが便利なところです。
x <- c("2026-01-05", "2026/02/14", "20260331")
ymd(x)
実行結果
[1] "2026-01-05" "2026-02-14" "2026-03-31"「年月日」の漢字が入った日付も変換できます。
ymd("2026年3月1日")[1] "2026-03-01"並び順が違う日付には、別の関数を使います。
| 関数 | 対応する形式 | 例 |
|---|---|---|
ymd() |
年・月・日 | 2026-03-15 |
mdy() |
月・日・年 | 03/15/2026(アメリカ式) |
dmy() |
日・月・年 | 15/03/2026(ヨーロッパ式) |
ymd_hms() |
年月日+時分秒 | 2026-03-15 21:30:00 |
年・月・日・曜日を取り出す
d <- ymd("2026-03-15")
year(d); month(d); day(d)
[1] 2026
[1] 3
[1] 15曜日は wday() で取り出します。label = TRUE にすると、数字ではなく曜日名になります。
wday(d, label = TRUE, locale = "ja_JP.UTF-8")[1] 日
Levels: 日 < 月 < 火 < 水 < 木 < 金 < 土※Windowsで日本語の曜日にならないときは、locale = "Japanese_Japan.932" を指定するか、locale を省略して英語表記(Sun, Mon…)で扱いましょう。
日付の計算
○日後・○か月後
d + days(10)
d %m+% months(1)
[1] "2026-03-25"
[1] "2026-04-15"月を足すときは %m+% を使うのがポイントです。たとえば1月31日に普通に1か月を足すと、存在しない「2月31日」になってNAになりますが、%m+% なら月末にそろえてくれます。
月初・月末
floor_date(d, "month")
ceiling_date(d, "month") - days(1)
[1] "2026-03-01"
[1] "2026-03-31"floor_date() は「切り捨て」、ceiling_date() は「切り上げ」です。月末は「翌月1日の1日前」として計算しています。
2つの日付の差(日数)
as.numeric(ymd("2026-03-31") - ymd("2026-01-01"))[1] 89最終購入日からの経過日数(リーセンシー)を計算するときなどに使えます。
時刻を含むデータ
dt <- ymd_hms("2026-03-15 21:30:00", tz = "Asia/Tokyo")
dt
hour(dt)
[1] "2026-03-15 21:30:00 JST"
[1] 21tz = "Asia/Tokyo" で日本時間を指定します。指定しないとUTC(世界標準時)として扱われ、GA4やBigQueryのデータと突き合わせたときに9時間ずれる原因になります。
実践:曜日別・週別に集計する
売上データ(sales.csv)(2026年1〜3月の日別・店舗別・カテゴリ別の売上)を使って、曜日ごとの平均客数を出してみます。
sales <- read.csv("sales.csv")

sales <- sales %>%
  mutate(
    date = ymd(date),
    week = floor_date(date, "week", week_start = 1),  # その週の月曜日
    wd = wday(date, week_start = 1)                    # 月曜=1 … 日曜=7
  )

sales %>%
  group_by(wd) %>%
  summarise(avg_customers = round(mean(customers), 1))
実行結果
# A tibble: 7 × 2
     wd avg_customers
  <dbl>         <dbl>
1     1          94.2
2     2          95.6
3     3          94
4     4          93.3
5     5          93.6
6     6         124
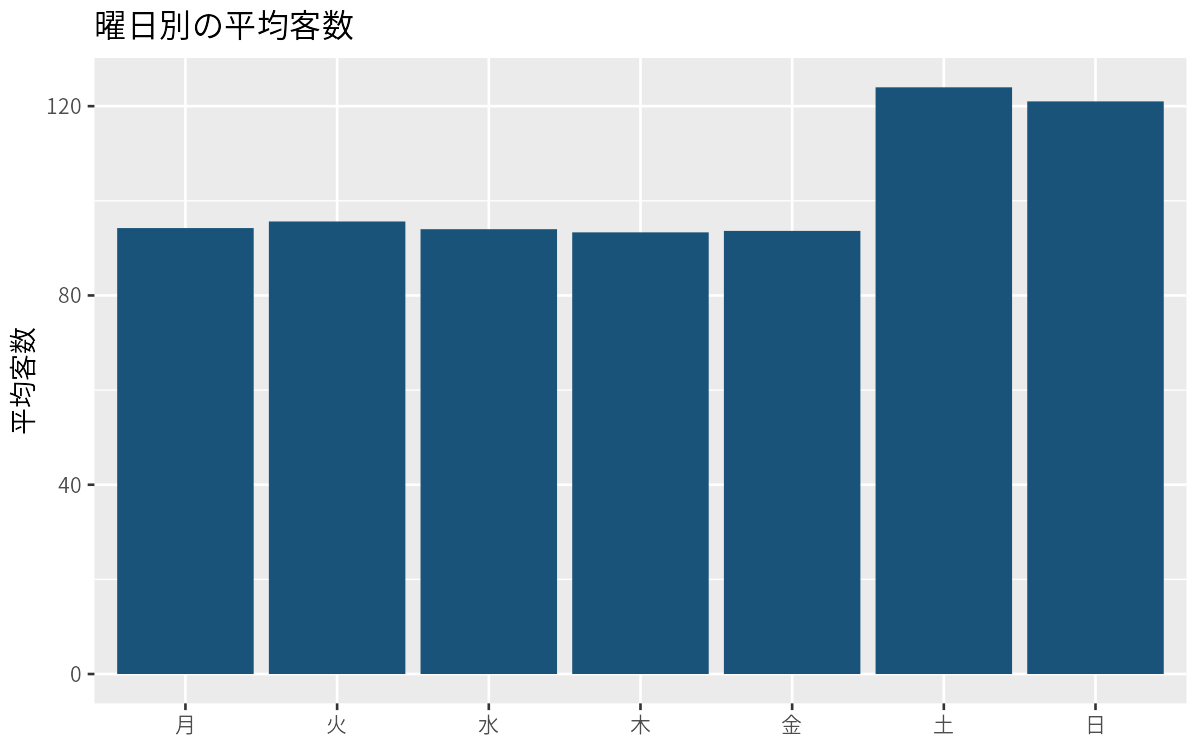
7 7 121 平日(1〜5)の平均客数が93〜96人なのに対して、土曜(6)は124人、日曜(7)は121人と、週末に客数が3割ほど増えることがわかります。
week_start = 1 は「週の始まりを月曜日にする」指定です。省略すると日曜日始まりになります。
曜日別のグラフ
記事の冒頭のグラフは、次のコードで作りました。
library(ggplot2)
theme_set(theme_gray(base_family = "Meiryo"))  # Macは "Hiragino Sans"

sales %>%
  mutate(wday = wday(date, label = TRUE, week_start = 1, locale = "ja_JP.UTF-8")) %>%
  group_by(wday) %>%
  summarise(customers = mean(customers)) %>%
  ggplot(aes(x = wday, y = customers)) +
  geom_col(fill = "#195379") +
  labs(title = "曜日別の平均客数", x = NULL, y = "平均客数")
label = TRUE で作った曜日は、月→火→…→日の順番を持った因子(factor)になっているので、グラフでも曜日の順に並びます。
週単位の集計
先ほど作った week 列で group_by() すれば、週ごとの売上推移も出せます。
sales %>%
  group_by(week) %>%
  summarise(sales = sum(sales))
まとめ
ymd()などで、文字の日付を日付型に変換するyear()・month()・wday()で、年・月・曜日を取り出せる- 月を足すときは
%m+%、月初・月末はfloor_date()・ceiling_date() - 時刻を含むデータは
tz = "Asia/Tokyo"を忘れずに floor_date(date, "week", week_start = 1)で週単位、wday()で曜日別に集計できる
日付を自由に扱えるようになると、「曜日」「週」「月」といった切り口で、データの傾向を見つけやすくなります。
同じことをGoogle ColabのPythonで行う方法は、Pythonで日付データを扱う方法【pandasのto_datetime・曜日・月初・週単位の集計】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。