
Rで満足度のドライバー分析をする方法【重回帰で改善の優先順位を決める】
 酒井 裕麻株式会社Bistro 代表取締役社長
顧客満足度アンケートでは、「味」「価格」「接客」など、いくつもの項目の満足度を聞くのが一般的です。でも、すべてを同時に改善するのは現実的ではありません。知りたいのは、「総合満足度を上げるために、どの項目から手をつけるべきか」です。
それを調べるのがドライバー分析です。この記事では、Rの重回帰分析で各項目の「総合満足度への影響度」を出し、CSポートフォリオ(改善の優先順位マップ)にまとめる方法を解説します。
参考記事
Rで回帰分析をする方法【lm関数・単回帰と重回帰・結果の読み方】
Rで相関分析をする方法【cor・cor.test・相関行列のヒートマップ】
アンケート調査の分析の進め方【設計から集計・レポートまでの7ステップ】
この記事で使うデータ
飲食店の顧客満足度アンケート(架空・500人分)cs_survey.csv を使います。6つの項目の満足度(1〜5の5段階)と、総合満足度(0〜10の11段階)を聞いています。
d <- read.csv("cs_survey.csv", fileEncoding = "UTF-8")
head(d)
round(colMeans(d), 2)
実行結果
  味 価格 接客 清潔さ 待ち時間 メニュー 総合満足度
1  3    1    4      5        1        3          5
2  5    4    4      4        5        4          9
3  4    2    5      3        2        2          6
4  4    3    5      3        3        3          8
5  4    4    5      3        5        4          9
6  3    2    3      2        3        4          6

        味       価格       接客     清潔さ   待ち時間   メニュー 総合満足度
      3.81       2.96       3.64       3.79       2.70       3.30       6.90
項目ごとの平均では、「味」(3.81)と「清潔さ」(3.79)の満足度が高く、「待ち時間」(2.70)と「価格」(2.96)が低くなっています。
ここで、「満足度の低い待ち時間と価格を改善しよう」と考えるのは、まだ早いです。満足度が低くても、総合満足度にあまり影響しない項目なら、改善しても総合満足度は上がらないからです。
相関だけで判断しない
まず、各項目と総合満足度の相関係数を見てみます。
round(cor(d)[1:6, "総合満足度"], 2) 味 価格 接客 清潔さ 待ち時間 メニュー
0.60 0.46 0.46 0.29 0.44 0.31 どの項目も、総合満足度とプラスの相関があります。ただし、アンケートの項目どうしは互いに相関しています(味に満足している人は、接客にも満足しやすいなど)。そのため、相関係数にはほかの項目の影響が混ざっています。
そこで、すべての項目を同時に入れた重回帰分析で、「ほかの項目の条件をそろえたときの、その項目だけの影響」を調べます。
重回帰分析で影響度を出す
m <- lm(総合満足度 ~ ., data = d)
summary(m)
総合満足度 ~ . の . は、「総合満足度以外のすべての列」という意味です。
実行結果
Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)  1.05530    0.25844   4.083 5.18e-05 ***
味           0.52939    0.04931  10.736  < 2e-16 ***
価格         0.48120    0.04852   9.918  < 2e-16 ***
接客         0.31262    0.04811   6.498 1.99e-10 ***
清潔さ       0.04165    0.05113   0.815    0.416
待ち時間     0.33332    0.04736   7.038 6.55e-12 ***
メニュー     0.06180    0.04786   1.291    0.197
---
Multiple R-squared: 0.5741, Adjusted R-squared: 0.5689 味・価格・接客・待ち時間の4項目は有意(***)で、清潔さとメニューは有意ではありませんでした。決定係数は0.57で、6つの項目で総合満足度のばらつきの約6割を説明できています。
標準化回帰係数で比べる
影響の大きさを項目どうしで比べるときは、データを標準化(平均0、標準偏差1にそろえる)してから回帰分析をした「標準化回帰係数」を使います。項目ごとに回答のばらつきが違っても、同じ物差しで比べられるようになります。
ds <- as.data.frame(scale(d))
ms <- lm(総合満足度 ~ ., data = ds)
round(coef(ms)[-1], 3)
実行結果
      味     価格     接客   清潔さ 待ち時間 メニュー
0.364 0.305 0.211 0.026 0.223 0.041 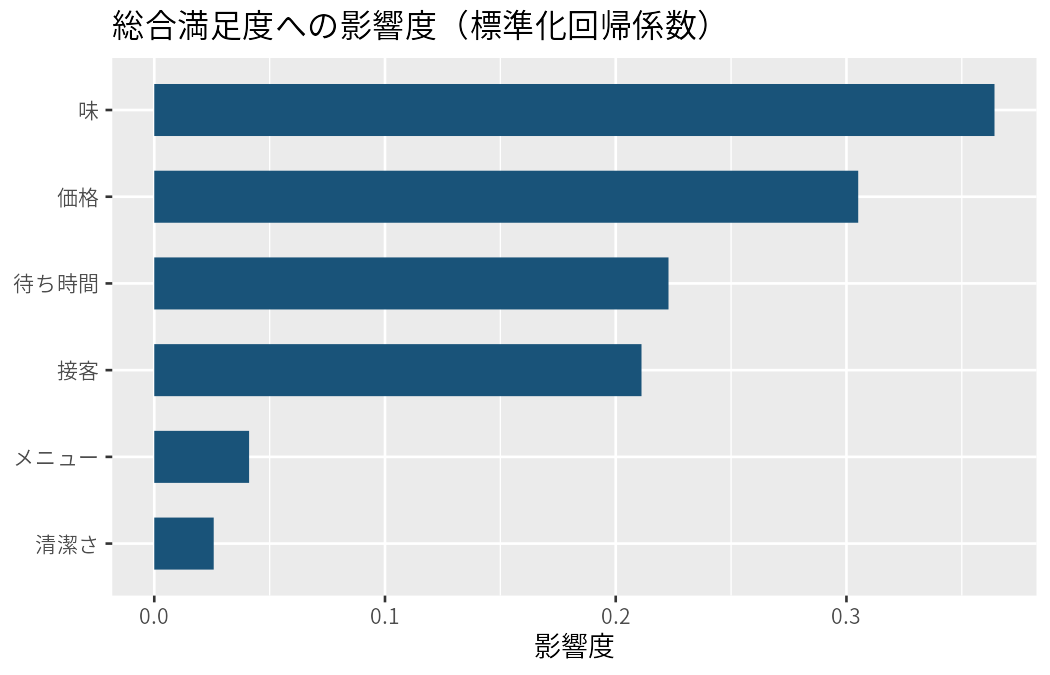
総合満足度への影響が最も大きいのは「味」、次いで「価格」「待ち時間」「接客」です。「清潔さ」と「メニュー」の影響はほとんどありません。
CSポートフォリオで優先順位を決める
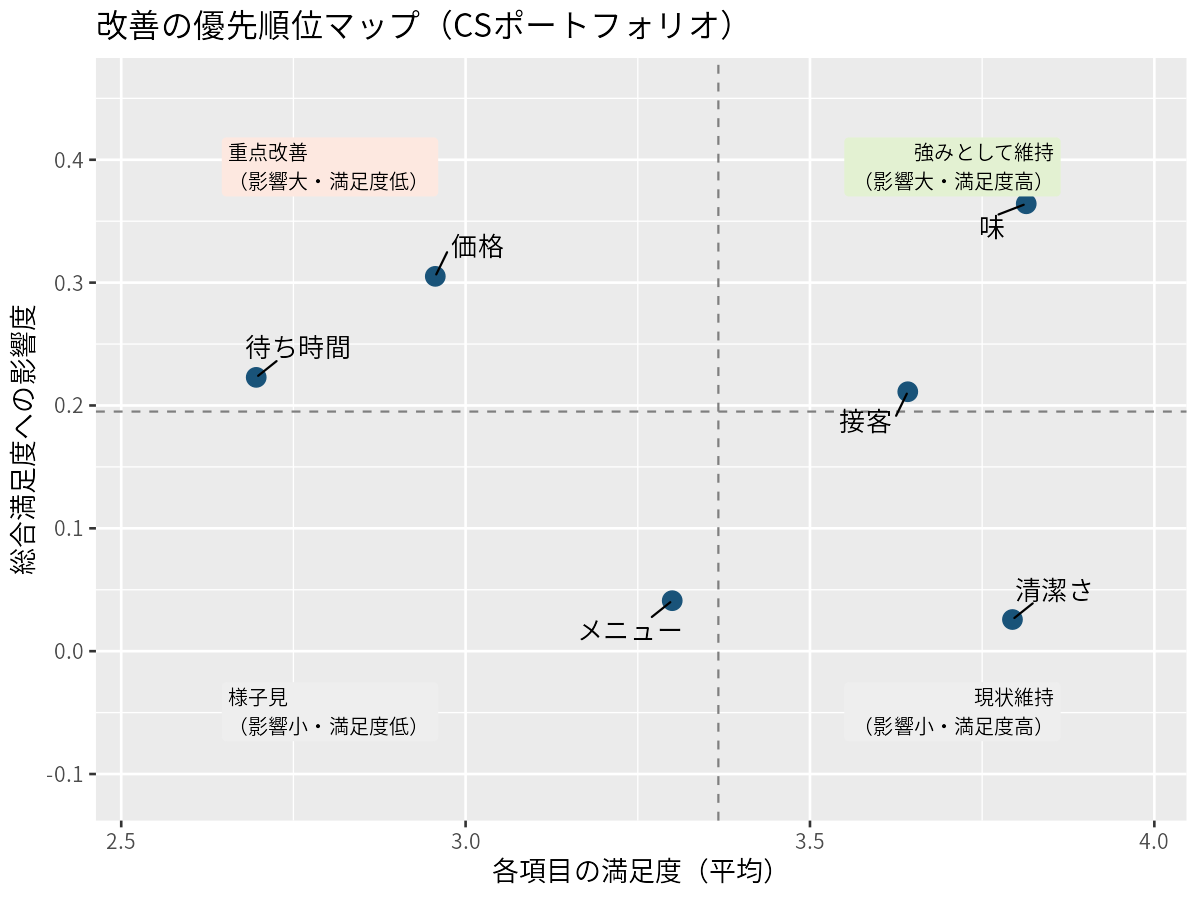
最後に、横軸に各項目の満足度(平均)、縦軸に総合満足度への影響度(標準化回帰係数)をとった散布図を作ります。これがCSポートフォリオです。
library(ggplot2)
library(ggrepel)
theme_set(theme_gray(base_family = "Meiryo"))  # Macは "Hiragino Sans"

imp <- data.frame(item = names(coef(ms))[-1], beta = coef(ms)[-1], score = colMeans(d[, 1:6]))

ggplot(imp, aes(score, beta)) +
  geom_hline(yintercept = mean(imp$beta), linetype = "dashed", color = "grey50") +
  geom_vline(xintercept = mean(imp$score), linetype = "dashed", color = "grey50") +
  geom_point(size = 4, color = "#195379") +
  geom_text_repel(aes(label = item), size = 4.5, seed = 1) +
  labs(title = "改善の優先順位マップ(CSポートフォリオ)", x = "各項目の満足度(平均)", y = "総合満足度への影響度")
点線は、満足度と影響度それぞれの平均です。この線で4つのエリアに分けて読みます。
| エリア | 意味 | 該当する項目 | アクション |
|---|---|---|---|
| 左上:重点改善 | 影響が大きいのに、満足度が低い | 価格・待ち時間 | 最優先で改善する |
| 右上:強みとして維持 | 影響が大きく、満足度も高い | 味・接客 | 今の水準を維持し、強みとして打ち出す |
| 右下:現状維持 | 影響は小さく、満足度は高い | 清潔さ | 今以上の投資は控えめでよい |
| 左下:様子見 | 影響も満足度も低い | メニュー | 優先度は低い |
この結果からは、「待ち時間を短くする工夫」と「価格の納得感を高める(値ごろ感のあるセット、量の見直しなど)」に取り組むと、総合満足度を効率よく上げられそうだ、と考えられます。逆に、満足度が低めの「メニューの豊富さ」は、総合満足度への影響が小さいので、優先度は下げてよさそうです。
ドライバー分析の注意点
- 項目どうしの相関が強すぎると不安定になる:たとえば「味」と「料理の質」のように、ほぼ同じことを聞いている項目を両方入れると、影響度がうまく分けられません。似た項目はまとめるか、主成分分析などで整理してから使います
- 影響度がマイナスになることがある:項目どうしの相関が強いときに起こりやすく、多くの場合は解釈しにくい結果です。相関係数と見比べて、おかしな結果になっていないか確認しましょう
- 因果関係とは限らない:「待ち時間の満足度が上がれば、総合満足度が上がる」は、あくまで今のデータでの関係です
- 改善のしやすさは別に考える:影響が大きくても、すぐには変えられない項目もあります。費用や実現性とあわせて、施策の順番を決めましょう
まとめ
- ドライバー分析は、「総合満足度を上げるには、どの項目を改善すべきか」を調べる方法
- 相関係数ではなく、重回帰分析でほかの項目の影響を取り除いて比べる
- 項目どうしの比較には、標準化回帰係数を使う
- 「満足度」と「影響度」の2軸のCSポートフォリオで、改善の優先順位が一目でわかる
満足度調査は、集計して終わりにせず、ドライバー分析で「次にどこを改善するか」まで落とし込むと、施策につながるレポートになります。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。