
Rでデータの縦持ち・横持ちを変換する方法【tidyrのpivot_longer・pivot_wider】
 酒井 裕麻株式会社Bistro 代表取締役社長
Excelで作られた表は、「月」が横に並んだ横長の形(横持ち)になっていることがよくあります。人が見るには読みやすい形ですが、Rで集計したりグラフにしたりするには、縦長の形(縦持ち)のほうが扱いやすくなります。
この記事では、tidyrパッケージの pivot_longer()(横→縦)と pivot_wider()(縦→横)を使って、表の形を自由に変換する方法を解説します。
参考記事
dplyrでデータ加工入門【filter・select・mutate・group_by・summarise】
ggplot2でグラフを作る方法【棒・折れ線・散布図と日本語の文字化け対策】
横持ちと縦持ちの違い
横持ち(Excelでよく見る形):1行に1店舗、月が列として横に並ぶ
| store | 1月 | 2月 | 3月 |
|---|---|---|---|
| 渋谷店 | 950 | 880 | 1010 |
縦持ち(Rで扱いやすい形):1行に1つの値。「どの店舗の」「どの月の」が列になる
| store | month | sales |
|---|---|---|
| 渋谷店 | 1月 | 950 |
| 渋谷店 | 2月 | 880 |
| 渋谷店 | 3月 | 1010 |
縦持ちにしておくと、group_by(month) で月ごとに集計したり、ggplot2で x = month と指定してそのままグラフにしたりできます。
この記事で使うデータ
3店舗の月別売上(万円)を、横持ちの形で作ります。
install.packages("tidyr")  # 最初の1回だけ
library(dplyr)
library(tidyr)

wide <- data.frame(
  store = c("渋谷店", "横浜店", "新宿店"),
  `1月` = c(950, 720, 1150), `2月` = c(880, 650, 1060), `3月` = c(1010, 810, 1230),
  check.names = FALSE
)
wide
実行結果
   store  1月  2月  3月
1 渋谷店  950  880 1010
2 横浜店  720  650  810
3 新宿店 1150 1060 1230※check.names = FALSE は、「1月」のように数字で始まる列名をそのまま使うための指定です。
pivot_longer():横持ち → 縦持ち
long <- wide %>%
  pivot_longer(cols = -store, names_to = "month", values_to = "sales")
long
実行結果
# A tibble: 9 × 3
  store  month sales
  <chr>  <chr> <dbl>
1 渋谷店 1月     950
2 渋谷店 2月     880
3 渋谷店 3月    1010
4 横浜店 1月     720
5 横浜店 2月     650
6 横浜店 3月     810
7 新宿店 1月    1150
8 新宿店 2月    1060
9 新宿店 3月 1230| 引数 | 意味 | この例では |
|---|---|---|
cols |
縦に並べ替える列 | -store(store以外のすべての列) |
names_to |
元の列名を入れる新しい列の名前 | "month" |
values_to |
元の値を入れる新しい列の名前 | "sales" |
cols は c("1月", "2月", "3月") のように列名を並べても指定できます。
縦持ちにすると、そのままグラフにできる
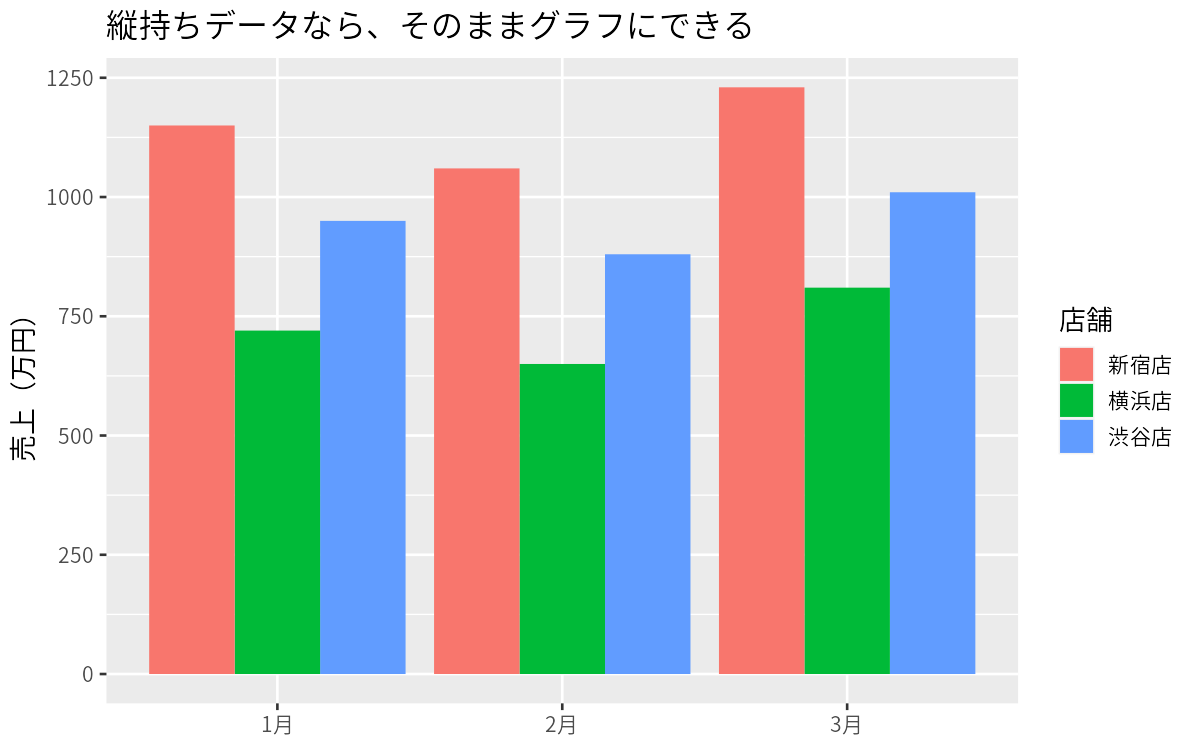
記事の冒頭のグラフは、縦持ちにした long から次のコードで作りました。
library(ggplot2)
theme_set(theme_gray(base_family = "Meiryo"))  # Macは "Hiragino Sans"

ggplot(long, aes(x = month, y = sales, fill = store)) +
  geom_col(position = "dodge") +
  labs(title = "縦持ちデータなら、そのままグラフにできる", x = NULL, y = "売上(万円)", fill = "店舗")
横持ちのままだと、ggplot2に「1月・2月・3月の列を横軸に」と伝えるのが難しく、縦持ちに変換するのが近道です。
pivot_wider():縦持ち → 横持ち
逆に、縦持ちのデータをレポート用の見やすい表にするときは pivot_wider() を使います。
long %>% pivot_wider(names_from = month, values_from = sales)実行結果
# A tibble: 3 × 4
  store  `1月` `2月` `3月`
  <chr>  <dbl> <dbl> <dbl>
1 渋谷店   950   880  1010
2 横浜店   720   650   810
3 新宿店 1150 1060 1230元の横持ちの形に戻りました。names_from に指定した列の値が、新しい列名になります。
行と列を入れ替えて、月を行、店舗を列にすることもできます。
long %>% pivot_wider(names_from = store, values_from = sales)# A tibble: 3 × 4
month 渋谷店 横浜店 新宿店
<chr> <dbl> <dbl> <dbl>
1 1月 950 720 1150
2 2月 880 650 1060
3 3月 1010 810 1230実践:集計結果をクロス表にする
dplyrで集計した結果をpivot_wider()でつなぐと、Excelのピボットテーブルのようなクロス表が作れます。売上データ(sales.csv)で、店舗×カテゴリの売上(万円)を出してみましょう。
sales <- read.csv("sales.csv")

sales %>%
  group_by(store, category) %>%
  summarise(sales = sum(sales) / 10000) %>%
  pivot_wider(names_from = category, values_from = sales)
実行結果
# A tibble: 3 × 4
# Groups:   store [3]
  store  日用品  食品  飲料
  <chr>   <dbl> <dbl> <dbl>
1 新宿店   700. 2336.  398.
2 横浜店   465. 1463.  254.
3 渋谷店   592. 1933.  316.
このまま write.csv() で書き出せば、Excelで開いてそのまま資料に使えます。
よくあるつまずき
| 症状 | 原因と対処 |
|---|---|
pivot_wider()で値がリスト(<list>)になる |
同じ組み合わせの行が複数ある。先に summarise() で1行にまとめるか、values_fn = sum を指定する |
| 月の並び順がおかしい(1月・10月・11月・2月…) | 文字として並べ替えられている。factor() で順番を指定する |
| 列名に記号やスペースがあってエラーになる | 列名を `1月` のようにバッククオートで囲む |
まとめ
- 横持ち → 縦持ちは
pivot_longer():集計やグラフ化の前に - 縦持ち → 横持ちは
pivot_wider():レポート用の表を作るときに - dplyrの集計とpivot_wider()を組み合わせると、ピボットテーブルのようなクロス表が作れる
「分析は縦持ち、見せるときは横持ち」と覚えておくと、データの形で迷わなくなります。
同じことをGoogle ColabのPythonで行う方法は、Pythonでデータの縦持ち・横持ちを変換する方法【pandasのmelt・pivot・pivot_table】で紹介しています。
NEWSLETTER
Data Schoolの新着記事をメールで受け取る
新しい記事が公開されたら、メールでお知らせします。配信はいつでも停止できます。